2026년 10월 24일 토요일 · Fluxaivory AI 브리핑 16호 · 18시 회차
문샷AI가 입력 100만 토큰당 2달러, 1,048,576토큰 문맥창을 제공하는 Kimi K3.1 Pro를 공개했습니다. Grok Bot의 자격증명 저장 기능과 Banyan Sapling의 판정 모델, Gemini Notebook의 대화창 연동도 새로 나왔습니다. Codex CLI의 재사용 명령까지, 모델의 성능·비용과 실제 작업을 맡길 때의 이용 조건을 비교했습니다.
오늘 담긴 것
- Kimi K3.1 Pro, 입력 100만 토큰 2달러: 기본 캐시 쓰기와 출력까지 합친 비용을 계산했다.
- Grok Bot Vault, 로그인·카드·연락처 저장: 자체 저장과 1Password 연동의 경계를 비교했다.
- Banyan Sapling, 평가 1,731건 중 779건 확정 판정: 계약서 평가의 확정 응답률은 0.82%였다.
- Gemini Notebook, 대화창에서 생성·수정·삭제: 개인 계정과 조직 계정의 설정 조건을 살폈다.
- Codex CLI 0.164.0, 프리셋 10개: 명령 재사용 방식과 속도별 크레딧 소모를 비교했다.
오늘의 톱
문샷AI, Kimi K3.1 Pro 공개…입력 100만 토큰 2달러
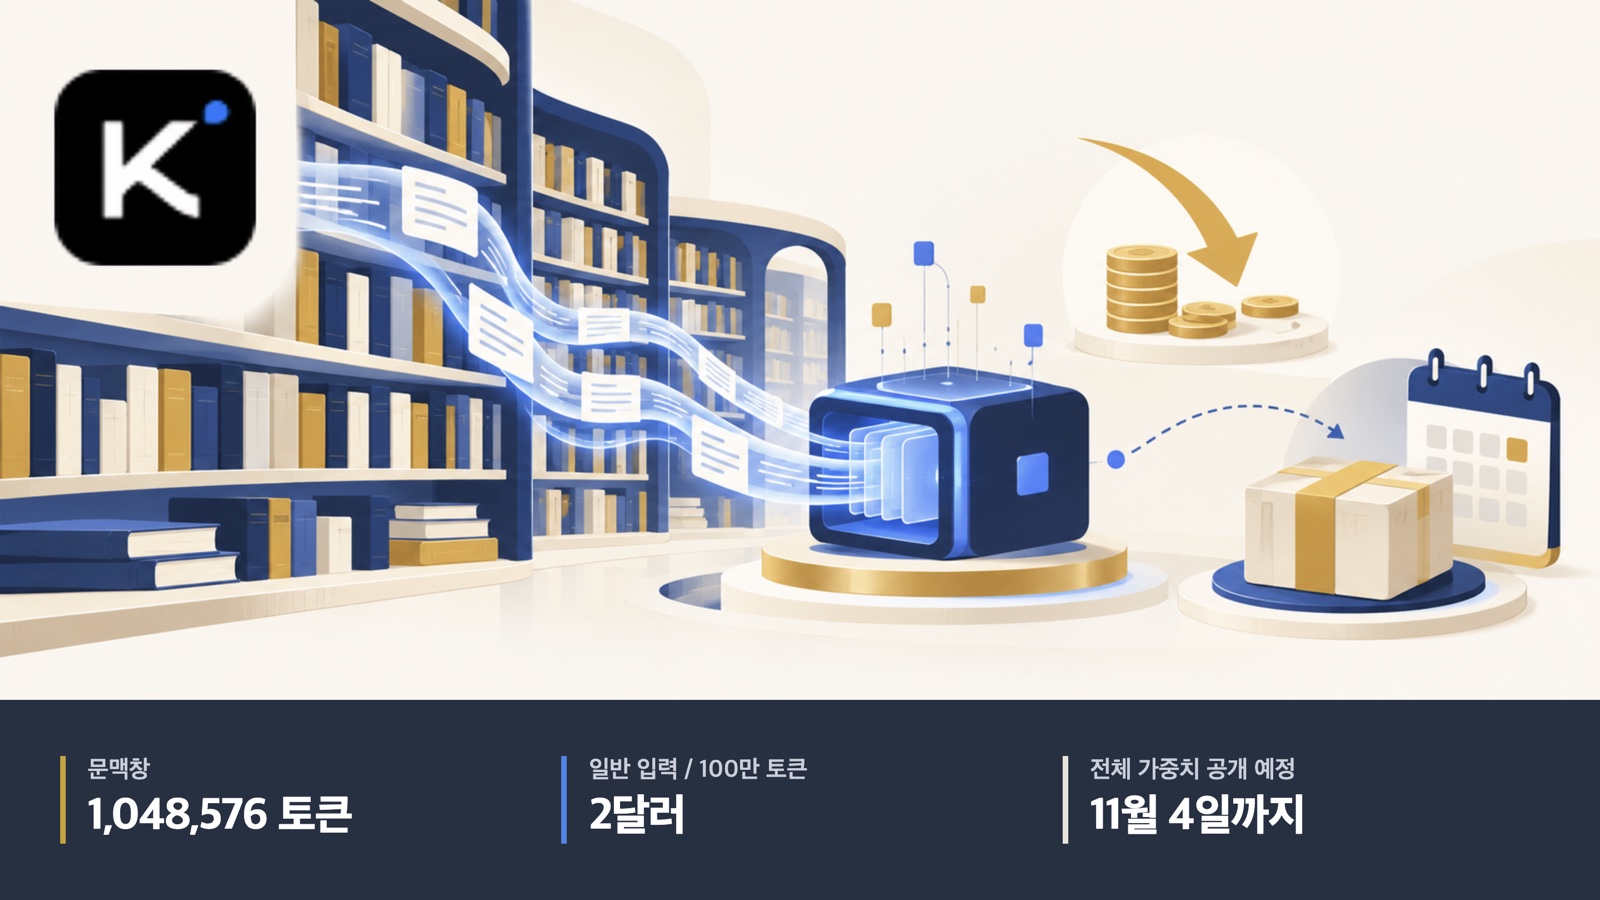
문샷AI(Moonshot AI)가 키미 K3.1 프로(Kimi K3.1 Pro)를 앱·웹·API에 제공하기 시작했다. 공식 발표에 따르면 전체 2.8조 파라미터 중 토큰마다 1,040억 개를 활성화하는 혼합 전문가 구조이며, 텍스트와 이미지를 읽는다. 문맥창은 1,048,576토큰이다.
- 가격: 일반 Pro는 입력 100만 토큰당 2달러, 출력은 10달러다.
- 제품: Kimi Work·Kimi Code·API에서 제공하며 Highspeed 버전도 함께 나왔다.
- 일정: 전체 모델 가중치 공개 목표는 2026년 11월 4일까지다.
무엇이 달라지나
기존 K3와 같은 입력·출력 양을 처리할 때 일반 Pro의 기본 단가는 약 33% 낮다. 긴 문서를 반복해서 읽는 팀은 모델의 정답률뿐 아니라 캐시 재사용 간격과 출력 길이까지 포함해 비교할 수 있다.
한계
가중치 공개는 향후 일정이며, 배포본의 라이선스 세부와 한국어 실사용 품질은 추가 확인 대상이다. 회사 자체 평가와 외부 종합 지수는 과제·도구·평가 방식이 달라 같은 척도로 합칠 수 없다. 아래 비용 예시는 세금과 별도 도구 요금을 제외한다.
자료
- 공식 모델 발표: 구조, 제품별 제공 경로와 가중치 공개 일정.
- 미국 달러 API 요금표: 일반·고속 모델과 캐시 단가.
- 캐시 과금 안내: 일반 입력·읽기·쓰기 토큰의 구분.
- Artificial Analysis 평가: 외부 지수와 출력 속도·토큰 사용량.
본문 펼치기 · 약 3분
가격·조건
공식 요금표의 일반 Pro는 입력·출력이 각각 100만 토큰당 2·10달러, Highspeed는 4·20달러다. 이전 K3의 단가는 3·15달러다. API는 사용량 기반 과금이며 Kimi 멤버십·Kimi Code와 별도 상품이다.
캐시 가이드에 따르면 총입력은 일반 입력, 캐시 읽기, 캐시 쓰기로 서로 겹치지 않게 나뉜다. 기본 5분 캐시 쓰기의 Pro 단가는 일반 입력과 같은 100만 토큰당 2달러다. 1시간 쓰기는 4달러, 캐시 적중 입력은 0.20달러다.
공식 단가표 기준으로 입력 100만 토큰을 일반 입력 또는 기본 5분 쓰기로, 출력은 10만 토큰으로 가정하면, Pro는 2+1=3달러다. 같은 양의 Highspeed는 4+2=6달러, K3는 3+1.50=4.50달러다. 동일 입력 전부가 캐시에 적중하면 Pro는 0.20+1=1.20달러, 전부 1시간 캐시에 새로 쓰이면 4+1=5달러다.
반복 호출 간격이 5분 안이면 적중할 때마다 유효기간이 갱신된다. 긴 문서의 내용·도구 정의를 앞에 고정하고 매번 바뀌는 질문을 뒤에 두는 방식이 이 구조에 맞는다. 비용 집계는 응답의 일반·캐시 읽기·쓰기 토큰을 따로 기록하면 된다.
벤치마크·비교
Artificial Analysis의 10월 24일 관측값은 Intelligence Index v4.3.2에서 55점, 출력 속도 초당 73토큰이다. 페이지의 비교 대상 중앙값은 각각 27점과 초당 82토큰이다. 점수와 출력 속도는 서로 다른 선택 기준이 된다.
같은 외부 평가에서 생성한 출력은 1억 5,000만 토큰으로, 표시된 중앙값 8,700만 토큰보다 많았다. 단가가 낮아도 추론·설명에 쓰는 출력량이 늘면 작업당 비용은 달라진다. 도입 비교에는 같은 문서·정답 기준과 최대 출력량을 고정한 사례 묶음이 유용하다.
문샷AI의 자체 평가는 법률·금융·코딩 등 업무별 과제를 따로 제시한다. 문서와 이미지가 함께 있는 실제 업무라면 종합 지수 하나보다 해당 업무에 가까운 평가 조건을 먼저 골라 볼 만하다.
궁금한 것
Q. 어디서 쓸 수 있나? 웹·모바일 Kimi, Kimi Work, Kimi Code와 API가 현재 제공 경로다. 공식 발표는 Work에 버전 3.1.0 이상을 안내한다.
Q. 더 빠른 버전은 가격도 같은가? Highspeed의 기본 입력·출력 단가는 일반 Pro의 두 배다. 요금표 기준으로 앞의 입력·출력 가정에서는 각각 6달러와 3달러다.
Q. 기존 K3 사용자는 무엇부터 비교하면 되나? 같은 입력 100만·출력 10만 토큰의 기본 비용은 4.50달러에서 3달러가 된다. 외부 평가의 출력량까지 함께 보고, 실제 작업에서 정답률·완료 시간·최종 청구액을 비교하면 된다.
AI를 우리 일에 적용하고 싶다면
모델 비용과 문서 처리, 에이전트의 권한·검증 기준을 업무에 맞춰 나누고 싶다면 Fluxaivory 운영자에게 문의할 수 있다.
함께 볼 소식
Grok Bot, Vault에 로그인·카드·연락처 저장
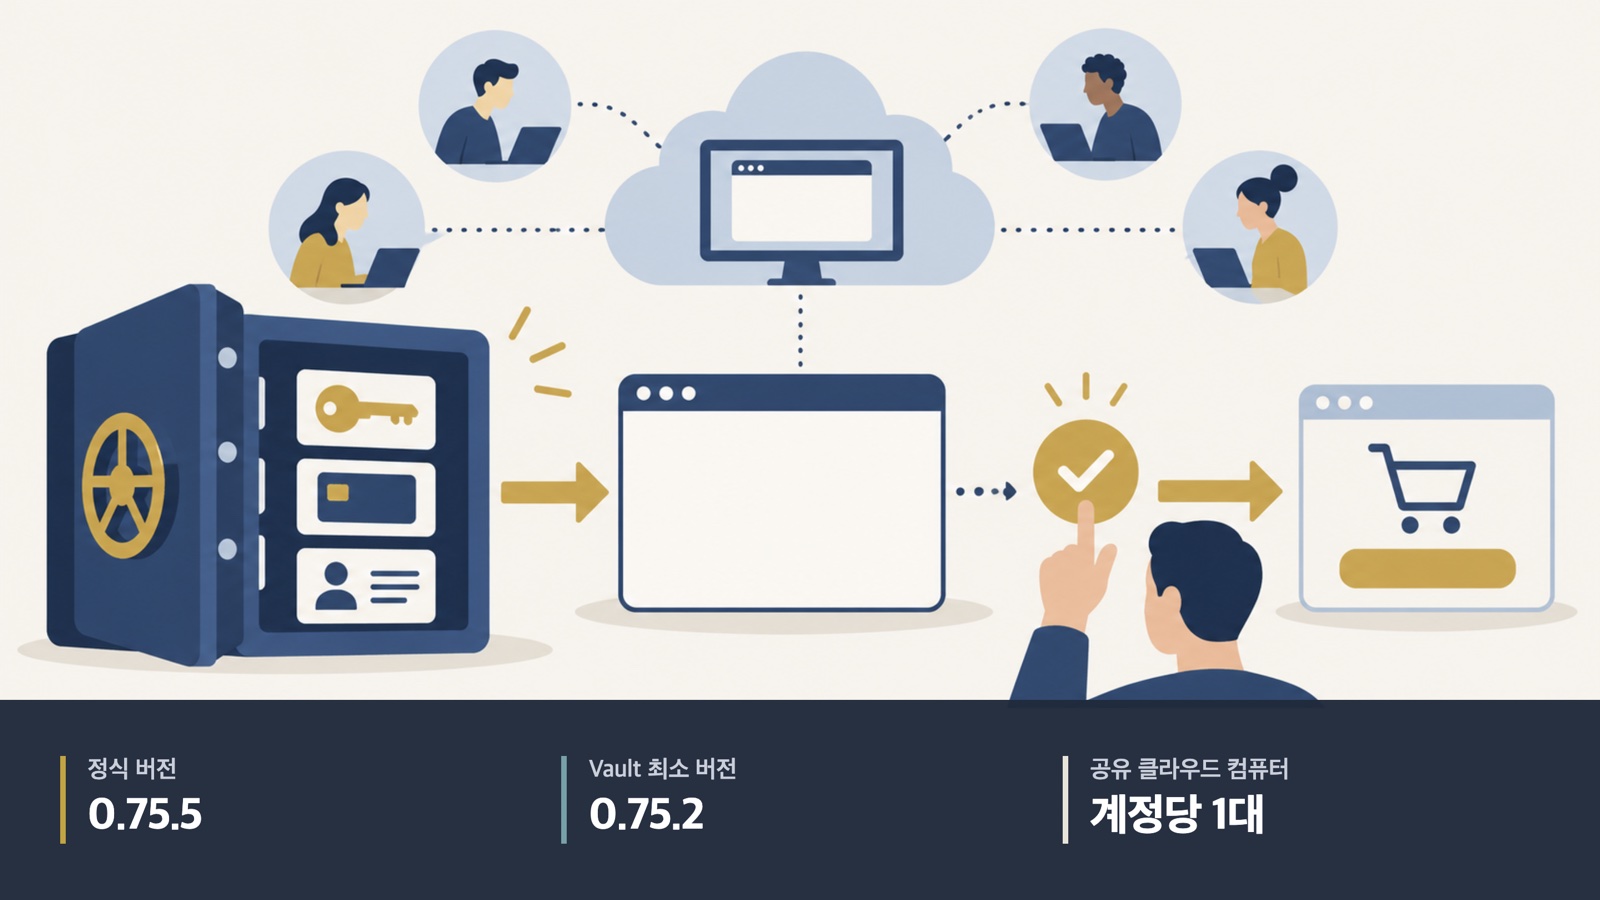
그록 봇(Grok Bot)이 로그인 정보·카드·연락처를 설정의 볼트(Vault)에 저장하고 웹사이트에 채우는 기능을 추가했다. 10월 23일 변경 기록의 정식 버전은 0.75.5이며, Vault 기능의 앱 요구 버전은 0.75.2 이상이다. 이메일 원형 전달과 승인 요청 방식 개선도 포함됐다.
- 저장: 사이트 로그인과 결제에 쓸 정보를 Vault에 보관한다.
- 버전: 최신 정식판은 0.75.5, Vault 사용 요구 버전은 0.75.2 이상이다.
- 승인: 명시적으로 요청한 이메일·Slack 전송은 Auto-review 허용 뒤 진행하고, 루틴 등의 전송은 초안으로 남긴다.
무엇이 달라지나
반복 로그인·체크아웃에서 같은 정보를 다시 입력하는 일이 줄어든다. 도입 판단은 저장 방식과 실행 승인 방식을 나눠야 한다. 자격증명을 준비하는 단계와 실제 전송·결제 동작을 승인하는 단계가 각각 생기기 때문이다.
한계
공개 보안 가이드는 10월 22일 갱신본이어서 새 Vault의 암호화 구현과 모델의 접근 범위까지 입증하지 않는다. 1Password 연동의 비밀번호 비노출 보장을 자체 Vault에 그대로 적용할 수도 없다. 봇 이름을 나누는 것만으로 계정 안의 공유 컴퓨터가 분리되는 것은 아니다.
자료
- 0.75.5 공식 변경 기록: Vault·이메일 전달과 승인 동작 변경.
- 승인·보안·개인정보 가이드: 공유 컴퓨터와 자동 승인 규칙의 범위.
- 1Password의 Grok Bot 연동: 자격증명 제공 방식과 체험 조건.
본문 펼치기 · 약 2분
활용·적용
보안 가이드는 한 사용자 계정에 속한 봇들이 클라우드 컴퓨터 하나를 공유한다고 설명한다. 그 컴퓨터의 파일·브라우저 세션·명령줄 자격증명은 해당 계정의 봇들 사이에서 이용될 수 있다. 서비스별로 사용할 계정·권한과 작업 종료 후 접근 해제 절차를 정해 두는 편이 운영 기준을 분명하게 만든다.
승인 규칙에는 먼저 묻기와 자동 허용이 있다. 둘 다 일치하면 먼저 묻기가 우선한다. 이번 변경 기록은 사용자가 거절한 동작을 다음 메시지 전까지 다시 시도하지 않도록 했다고도 안내한다.
벤치마크·비교
새 Vault는 로그인·카드·연락처를 Bot 설정에 보관하는 경로다. 1Password 연동은 1Password에 저장한 로그인을 사용자가 승인해 제공하는 경로이며, 비밀번호와 일회용 코드를 Bot에 보여 주지 않고 채운다고 명시한다. 기존 비밀번호 관리 체계를 유지할 팀은 저장소와 접근 해제 위치를 기준으로 두 경로를 비교할 수 있다.
1Password for Agents는 Individual·Family 요금제에 포함된다. 같은 공식 페이지는 14일 무료 체험을 안내한다. 사용자가 새 저장소를 만들기 전에 기존 연동으로 작업을 충족할 수 있는지 점검할 경로다.
궁금한 것
Q. 어느 버전을 설치해야 하나? 공식 변경 기록은 Vault에 0.75.2 이상을 요구하고, 최신 정식 버전을 0.75.5로 표시한다.
Q. 정보가 저장되면 모든 작업이 자동 실행되나? 자격증명 저장과 실행 승인은 별개다. 보안 가이드의 먼저 묻기 규칙으로 전송·게시·구매 등의 승인 경계를 정할 수 있다.
Q. 봇을 지우면 로그인도 정리되나? 보안 가이드는 봇 삭제와 공유 컴퓨터의 파일·브라우저 세션 삭제를 구분한다. 종료 절차는 서비스 로그아웃, 연결 해제, 원 서비스의 권한 회수까지 포함해 정하면 된다.
뮤빗, Banyan Sapling 공개…평가 45%에 확정 판정
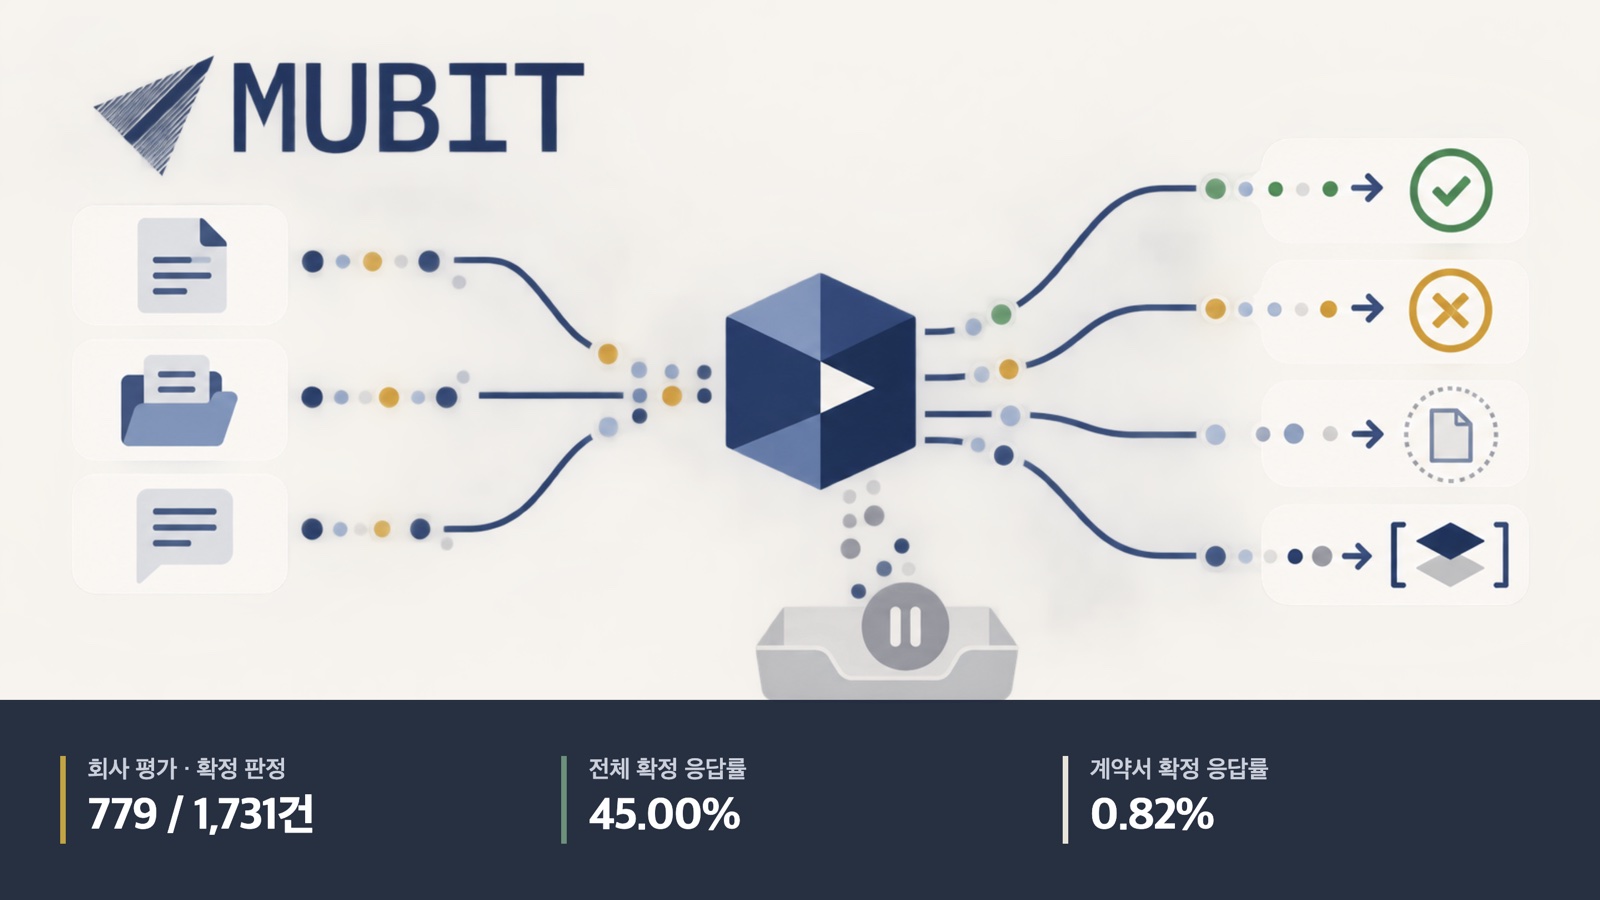
뮤빗(Mubit)이 정책·근거·주장을 함께 읽는 바니언 새플링(Banyan Sapling)의 연구 프리뷰 가중치를 공개했다. 모델 카드에 따르면 판정 종류는 지지·위반·정보 부족·문맥 모순의 네 가지다. 개발사 평가 1,731건 중 779건에 확정 판정을 내렸고, 이 779건은 모두 기준 라벨과 일치했다.
- 응답: 전체 1,731건의 45.00%를 확정했고 952건은 `unsure` 상태였다.
- 계약서: ContractNLI 731건에서는 6건, 0.82%만 확정 판정을 내렸다.
- 배포: 약 230억 파라미터의 공개 가중치를 Apache 2.0으로 제공한다.
무엇이 달라지나
답을 반드시 하나로 밀어붙이는 대신, 근거가 부족하거나 문맥이 충돌하는 경우와 판정을 보류하는 경우를 구분하는 구성 요소가 생겼다. 정해진 정책의 반복 확인에는 확정 결과뿐 아니라 보류 큐의 크기까지 함께 비교할 수 있다.
한계
779건의 일치율은 확정한 부분집합의 결과이지 모든 입력에서 정확하다는 보장이 아니다. 평가에는 기존 벤치마크 노출과 같은 문서에서 나온 상관된 사례가 포함됐으며, 영어 중심이다. 실제 조직의 새 문서에서 성능을 독립적으로 검증한 결과는 아니다.
자료
- 공식 모델 카드·가중치: 입력 필드, 네 판정과 보류 상태, 실행 환경.
- 평가 보고서: 확정 비율과 계약서·합성 데이터 차이.
본문 펼치기 · 약 2분
벤치마크·비교
개발사 평가의 보정 전 최상위 클래스 정확도는 전체 94.22%였다. 보정 후 확정 응답은 779건으로 줄었고, 나머지 952건은 보류됐다. `unsure`는 별도의 다섯 번째 의미 클래스가 아니라 보정된 판정이 확정되지 않은 상태다.
평가 보고서에서 합성 데이터 1,000건의 확정 비율은 77.30%지만, 계약서 731건은 0.82%다. 계약서 쪽 보정 전 정확도는 86.32%였다. 계약서 실무를 평가할 때에는 정답률과 함께 사람이 다시 봐야 하는 사례의 비율을 먼저 측정할 가치가 있다.
같은 보고서의 H200 기준 팟(pod) 내부의 순차 HTTP 요청 지연은 중앙값 97.08ms, 95백분위 111.33ms다. 이는 해당 기준 사례·환경의 관측값이며, 서비스 설계에는 요청 길이와 동시 실행 수를 바꾼 측정이 이어져야 한다.
활용·적용
공개 배포본은 가중치·토크나이저·보정 값·전용 로더를 제공한다. 가중치는 Apache 2.0, 함께 제공하는 코드는 MIT다. 무료 평가 경로는 이 배포본으로 자체 사례를 검증하는 방식이다.
입력은 비어 있지 않은 정책·근거·주장 세 문자열이며, 16,384토큰 한도는 이 세 필드와 형식을 모두 합한 값이다. BF16 체크포인트의 디스크 크기는 약 46GB이고 추론 메모리가 추가로 필요하다. 기준 실행 환경은 NVIDIA H200이다.
궁금한 것
Q. 어떤 일을 맡기는 모델인가? 제공된 정책과 근거에 비춰 주장을 분류한다. 모델 카드는 자료 검색·출처 인증·설명 생성·최종 업무 결정을 주변 시스템의 역할로 나눈다.
Q. 정보 부족과 판정 보류는 같은가? `insufficient_information`은 네 의미 클래스 중 하나다. `unsure`는 보정된 예측이 하나로 정해지지 않은 상태이며, 평가 보고서는 확정 응답률을 따로 집계한다.
Q. 첫 평가에서는 무엇을 세면 되나? 공식 평가 항목을 참고해 확정 응답률, 잘못된 지지 판정, 보류 후 사람 검토량을 함께 센다. 실제 업무 문서 단위로 평가 사례를 나누면 같은 문서가 반복되는 효과도 점검할 수 있다.
Gemini Notebook, 대화창에서 생성·수정·삭제
구글이 제미나이 노트북(Gemini Notebook)을 제미나이 앱의 연결된 앱으로 추가했다. 10월 23일 발표에 따르면 대화에서 `@Gemini Notebook`을 선택해 노트북과 자료를 관리하고 내용을 질의할 수 있다. 관련 요청에는 제미나이가 자동으로 연동 앱을 고를 수도 있다.
- 작업: 노트북 생성·수정·삭제, 자료 추가·갱신·삭제와 조회를 지원한다.
- 대상: 모든 Workspace 고객, Workspace Individual 구독자와 개인 Google 계정에 제공한다.
- 설정: 전 세계 기본 켜짐이며 EEA는 기본 꺼짐이다. 조직은 두 서비스가 모두 켜져 있어야 한다.
무엇이 달라지나
자료를 정리하는 화면과 그 자료를 활용해 질문하는 대화를 연결한다. 현재 대화를 기존 노트북의 소스로 추가하거나, 노트북의 내용을 불러와 후속 작업을 이어 가는 흐름을 만들 수 있다.
한계
실제 연결 목록과 지원 동작은 계정 유형·지역·언어·단말에 따라 달라진다. 개인 계정 도움말과 직장·학교 계정의 관리 정책은 적용 범위를 구분해야 한다. 노트북과 자료의 삭제까지 포함하는 기능이므로 읽기 전용 조회와 변경 작업의 범위를 요청에 나눠 적는 편이 좋다.
자료
- Google 공식 제공 안내: 계정별 대상, 전 세계 기본 설정과 조직 조건.
- Connected Apps 도움말: 계정 연결, 활동 설정과 앱별 지원 동작 확인.
본문 펼치기 · 약 2분
활용·적용
공식 예시는 새 노트북 만들기, 현재 대화를 노트북 소스로 추가하기, 노트북 목록 확인과 내용 질의를 포함한다. 처음에는 특정 노트북을 조회하는 요청부터 구성하고, 자료를 추가하거나 삭제하는 작업은 대상 이름과 범위를 명시하면 된다.
개인 계정 도움말은 연결된 앱의 상세 페이지에서 지원·미지원 동작과 예시 요청을 확인하도록 안내한다. 새 연동의 지원 범위를 메뉴에서 읽어 본 뒤 업무 절차에 넣는 경로다.
가격·조건
제공 안내의 전 세계 기본 켜짐 범위에는 한국도 포함된다. 기관 계정은 해당 그룹·조직 단위에서 Gemini와 Gemini Notebook이 모두 켜져 있어야 한다. 두 서비스 중 하나만 허용하는 운영 환경은 관리자 설정부터 점검할 수 있다.
개인 계정에서는 활동 보관 설정도 조건이 된다. 도움말에 따르면 Keep Activity를 끄면 웹·iOS·스마트워치에서 Connected Apps를 사용할 수 없다. Android의 예외는 기기 지원·전화·메시지·WhatsApp이며 노트북 연동은 여기에 포함되지 않는다.
궁금한 것
Q. 개인 계정도 대상인가? 그렇다. 공식 발표는 개인 Google 계정과 Workspace Individual도 대상에 포함한다.
Q. 대화에서 어떻게 앱을 지정하나? `@Gemini Notebook`을 선택한다. 일반 연동 도움말은 연결 전인 앱을 고르면 연결하거나 권한을 묻는 흐름을 안내한다.
Q. 회사 계정에서는 어디부터 확인하나? 관리자 조건의 두 서비스 허용 상태와 개인의 연결된 앱 목록을 확인한다. 조회·자료 추가·삭제를 각각 나눠 시험할 범위를 정하면 된다.
Codex CLI 0.164.0, 프리셋 10개·인라인 설정
오픈AI가 10월 23일 코덱스 CLI(Codex CLI) 0.164.0을 정식 배포했다. 릴리스 기록은 자주 쓰는 요청문·슬래시 명령을 저장하는 열 개의 프리셋 슬롯과 인라인 모델·권한 설정을 추가했다. 지원 터미널에서는 전체 화면 대화에 이미지도 미리 볼 수 있다.
- 재사용: `/presets`의 번호 슬롯 열 개에 요청문과 명령을 저장한다.
- 설정: `/model`과 `/permissions`의 인자로 모델·추론·속도·권한 프로필을 고른다.
- 터미널: 이미지 미리보기는 Kitty 또는 Sixel 그래픽 지원 환경이 대상이다.
무엇이 달라지나
반복 작업의 지시와 실행 설정을 더 짧게 재사용할 수 있다. 팀의 도입 기준은 단축 명령을 만드는 편의성과 모델의 속도별 사용량, 실제 파일·네트워크 권한을 따로 점검하는 쪽으로 나눌 수 있다.
한계
클라이언트의 기능 추가가 모델 성능 향상이나 모든 환경의 비밀정보 마스킹을 뜻하지는 않는다. 속도별 크레딧 배수와 구독 포함 사용량 배수도 다르다. 아래 크레딧 계산을 구독의 고정 작업 수나 달러 금액으로 바꿔 읽을 수는 없다.
자료
- 0.164.0 정식 릴리스: 프리셋, 설정과 환경별 수정 사항.
- 권한·보안 가이드: 샌드박스·승인·네트워크의 적용 범위.
- 공식 요금·크레딧 표: 구독 경로와 모델·속도별 사용량.
- Claude Code의 스킬: 파일 기반 재사용 명령과의 비교 자료.
본문 펼치기 · 약 3분
벤치마크·비교
Codex의 열 개 슬롯은 자주 쓰는 요청을 빠르게 불러오는 기능이다. 클로드 코드(Claude Code)는 파일로 저장한 지침을 슬래시 명령으로 호출한다. `.claude/commands/deploy.md`와 `.claude/skills/deploy/SKILL.md`는 모두 `/deploy`를 만든다.
Codex도 별도 스킬을 제공한다. 여기서는 새 프리셋 슬롯과 Claude Code 스킬의 재사용 방식을 비교했다.
스킬 경로에는 관련 파일을 함께 두고 호출 조건도 지정할 수 있다. 짧은 개인 작업은 빠른 슬롯에, 여러 파일·절차를 공유하는 팀 작업은 파일 기반 지침에 맞춰 설계할 수 있다. 두 기능은 실행 결과의 품질을 재는 벤치마크보다 지침을 보관하고 배포하는 방식의 차이로 비교하는 편이 유용하다.
가격·조건
공식 가격표는 Plus 월 20달러에 CLI·웹·IDE 등의 이용을 포함하고, API 키는 별도 사용량 요금 경로로 구분한다. 구매 크레딧·기업 종량제의 GPT-6.1 Sol Standard 단가는 입력 100만 토큰당 50크레딧, 출력은 250크레딧이다.
속도별 요금표 기준으로 캐시 적중 없이 입력 100만·출력 10만 토큰을 사용한다고 가정하면 50+25=75크레딧이다. 해당 속도 모드가 허용되는 환경에서 같은 양은 Fast 2배인 150크레딧, Ultrafast 6배인 450크레딧이다. 반면 구독 포함 사용량은 Fast가 Standard 대비 2.5배, Ultrafast가 8배 소모된다.
활용·적용
권한 문서는 샌드박스를 기술적 파일·네트워크 범위로, 승인 정책을 언제 사용자에게 물을지의 규칙으로 구분한다. 명령용 네트워크 프록시의 정책 범위는 셸 명령과 그 자식 프로세스다. MCP·브라우저·앱·검색·모델 연결은 각 기능의 별도 통제를 함께 점검해야 한다.
궁금한 것
Q. 반복 요청은 어떻게 저장하나? 릴리스 안내의 `/presets`와 번호 슬롯을 사용한다. 키보드 메뉴로 빠르게 불러오는 경로도 추가됐다.
Q. 모델과 속도는 어디서 고르나? `/model`의 인라인 인자를 통해 모델·추론 강도·속도를 지정한다. 공식 가격표의 속도별 소모량을 함께 보고 작업의 응답 시간 목표를 정하면 된다.
Q. 실행 권한은 어디서 확인하나? `/permissions`에서 권한 프로필을 고르고, 보안 문서의 샌드박스·승인·네트워크 범위를 대조한다. 읽기 전용 검토와 파일 변경 작업의 설정을 나눠 둘 수 있다.
이미지와 정정: 일러스트는 AI 생성 이미지다. 정정·문의는 문의 페이지로 받을 수 있다.
자료 확인: 2026년 10월 24일 공식 발표·문서와 외부 평가를 대조했으며 API·모델을 직접 실행하지 않았다. ‘궁금한 것’은 기본 질문 세트에서 골랐다.