2026년 10월 26일 월요일 · Fluxaivory AI 브리핑 21호 · 오전 0시 회차
텐센트가 글과 카메라 이동으로 이어 만드는 720p 월드 모델 하이노마스를 공개했습니다. 로봇 제어 API Dream-1의 외부 평가와 요금, Ming-3.0의 한국어 음성 합성 결과도 확인했습니다. 휴대폰 앱을 다루기 시작한 Grok Bot과 아직 예고 단계인 Hermes를 비교하며, 25일 새로 소개된 소식의 최초 발표일과 현재 제공 조건을 나눠 정리했습니다.
오늘 담긴 것
- 하이노마스, 글·카메라로 이어 만드는 720p 세계: RTX 4090용 구성과 표준 실행의 차이.
- Dream-1, 로봇 제어 API 시간당 3달러: 외부 과제 점수와 실제 로봇·시뮬레이션 범위.
- Ming-3.0, 한국어 포함 7개 언어 음성 합성: 작은 모델과 Tiny의 한국어 오류율 비교.
- Grok Bot, 휴대폰 캘린더·연락처 연결: 한국 앱스토어 제공 조건과 구독료.
- Hermes, 모바일 앱 예고: 공식 앱 미출시 공지와 개발자 표시 확인.
오늘의 톱
텐센트, 하이노마스 공개…720p 세계를 글·카메라로 조작
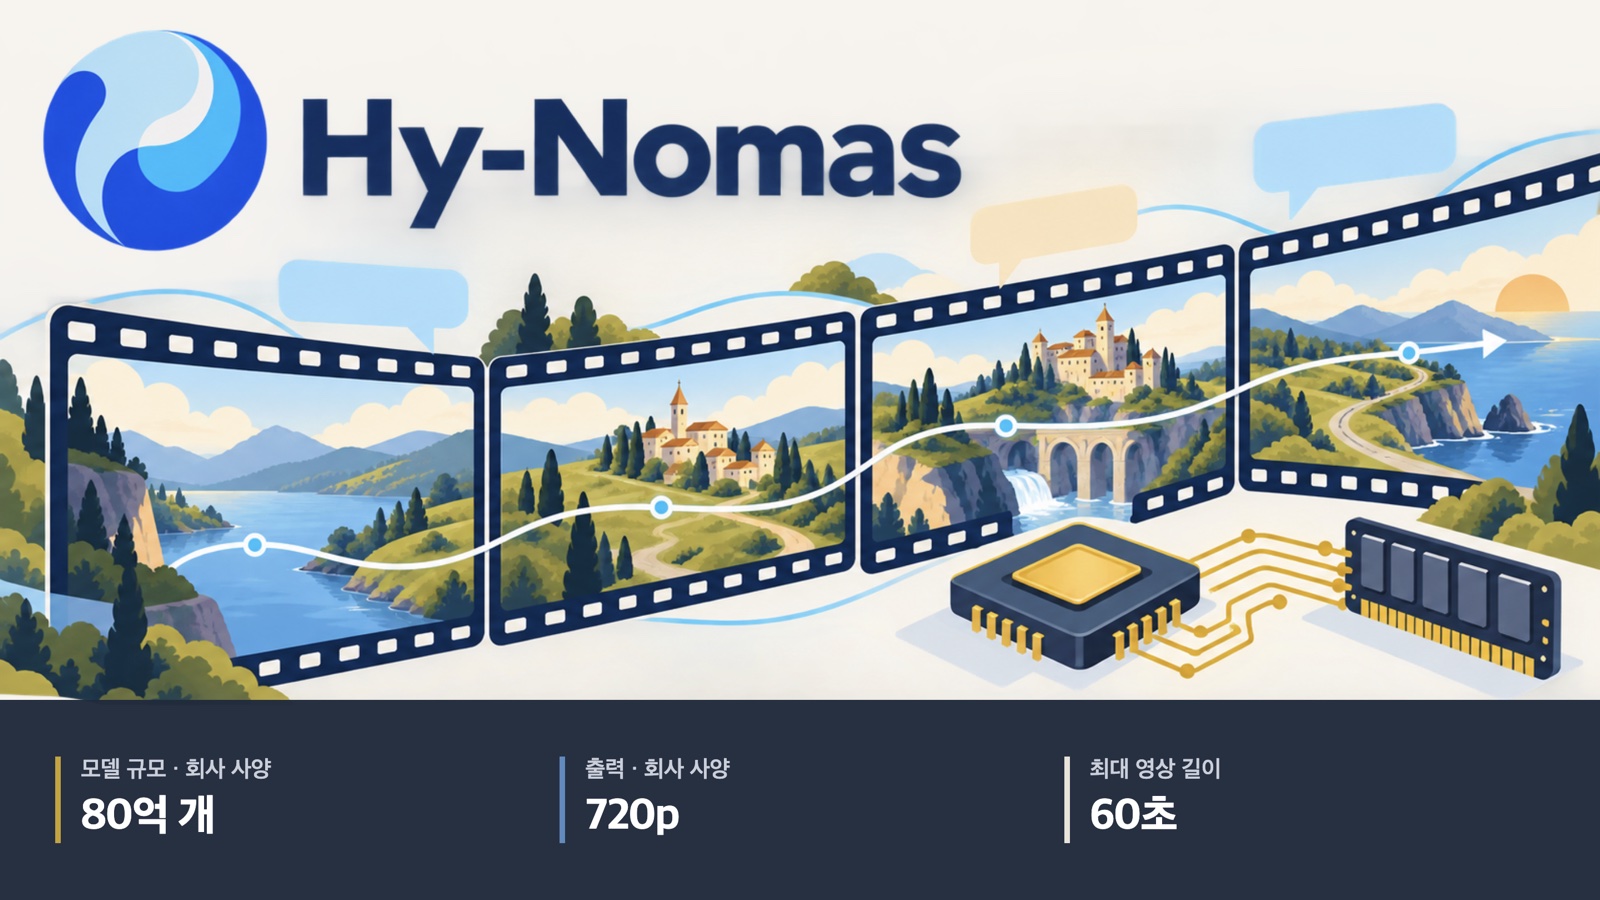
텐센트(Tencent)의 하이노마스(Hy-Nomas)는 글로 장면을 지시하거나 카메라 경로를 바꾸면서 영상을 구간별로 이어 만드는 월드 모델이다. 공식 페이지는 80억 매개변수, 720p 출력, 최대 60초 영상과 36만 토큰 문맥을 제시한다. 코드 저장소에는 10월 23일 초기 커밋이 있으며, 이번 회차는 25일 밤 한국어 재소개를 계기로 공개 범위를 확인했다.
- 조작: 텍스트 지시와 카메라 이동을 번갈아 입력하고, 앞선 구간의 정보를 다음 구간에 전달한다.
- 공개: 추론·학습·데이터 주석 코드와 모델 가중치, 영화적 표현·로봇 영상용 추가 학습 모델을 제공한다.
- 장비: 표준 구성은 GPU 8개를 쓰며, RTX 4090 한 장용 저메모리 구성을 별도로 제공한다.
무엇이 달라지나
고정된 글 입력으로 영상 한 편을 뽑는 방식에서, 진행 중인 세계에 물체·행동·시점 변화를 순서대로 넣는 방식으로 확장된다. 개발자는 생성 화면뿐 아니라 이전 장면을 얼마나 유지하는지와 지시를 어느 구간에 적용하는지를 따로 비교할 수 있다.
한계
최대 60초는 출력 길이이며, 출력 영상의 24fps가 실시간 생성 속도를 뜻하지는 않는다. 4090 구성은 CPU 메모리 이동에 따른 지연과 충분한 시스템 RAM이 필요하고 최대 메모리 사용량은 해상도·구간 길이에 좌우된다. 한국어 품질과 국내 데모 이용 조건은 확인되지 않았으며 직접 생성하지 않았다.
자료
- 공식 소개와 시연: 모델 사양과 장면 기억·시점 조작 사례.
- 공식 실행 코드: 표준·저메모리 구성, 학습과 데이터 준비.
- 공식 가중치와 모델 카드: 구성 요소, 출력 규격, 라이선스.
- 한국어 재소개: 25일 밤 소개, 소수 게시물 기준.
본문 펼치기 · 약 2분
활용·적용
모델 카드는 장면을 영상 구간 단위로 생성하고, 앞선 구간의 키·값 캐시를 다음 구간으로 넘기는 구조를 설명한다. 캐시는 이전 내용을 이어받는 기억 장치에 해당한다. 같은 공간에서 시점을 옮겼다가 돌아오는 장면, 물체를 새로 넣는 장면처럼 연속성과 조작이 중요한 시각 시제품에 비교할 여지가 있다.
공식 코드의 저메모리 구성은 가중치와 캐시를 INT8로 저장하고 주요 연산은 BF16으로 수행한다. 활성 캐시의 범위를 제한하고 텍스트 인코더·생성 모델·디코더를 순서대로 GPU에 올렸다 내린다. 기본 설정을 그대로 실행하는 경로와 단일 GPU 경로는 서로 다른 실행 구성이다.
벤치마크·비교
같은 인터랙티브 영상 분야의 에덴라이브(EdenLive)는 게임 엔진이나 코드가 규칙과 상태를 관리하고, 그 참고 화면을 AI가 정교하게 렌더링한다. 반면 하이노마스는 텍스트·카메라 지시와 영상 이력을 받아 다음 영상 구간을 생성한다. 게임의 충돌·점수·위치처럼 정확한 상태가 필요한 팀은 두 방식의 역할 분담부터 비교할 수 있다.
텐센트가 공개한 Hy-Nomas-Bench 설명은 280개 사례를 네 평가군으로 나눈다. 다중 텍스트 지시, 카메라 탐색, 두 입력의 교대, 공간 기억이 대상이다. 이는 평가 자료의 구성으로, 다른 모델보다 우수하다는 점수 발표와는 구분된다.
가격·조건
코드와 가중치 카드는 Apache 2.0을 안내한다. 카드에는 외부 모델·구성 요소에는 각각의 라이선스가 적용된다는 조건도 있다. 자체 실행을 검토한다면 모델 사용권과 함께 Qwen 텍스트 인코더 등 함께 쓰는 구성 요소의 조건을 묶어 확인하는 방식이 맞다.
궁금한 것
Q. 4090 한 장으로 실행하는 경로가 있어? 있다. 공식 저장소는 단일 RTX 4090용 설정 파일과 양자화된 생성 모델·FP8 디코더 조합을 제시한다. 표준 설정은 8개 GPU를 사용하는 별도 경로다.
Q. 영상의 겉모습만 바꾸는 도구야? 하이노마스는 글과 카메라 경로를 받아 다음 구간을 생성한다. 엔진이 만든 참고 화면의 외형을 바꾸는 EdenLive와 입력 구조가 다르다.
Q. 직접 학습할 자료 준비 코드도 있어? 저장소는 로컬 영상에 구간별 설명을 붙이고 잠재 표현으로 변환하는 도구, 시퀀스 묶기와 LoRA 추가 학습 절차를 제공한다. 공개된 기능 범위는 추론만이 아니다.
AI를 우리 일에 적용하고 싶다면
먼저 시험할 작업과 장비·비용·권한·검수 기준을 나누고 싶다면 Fluxaivory 운영자에게 문의할 수 있다.
함께 볼 소식
Dream Labs, 드림-1 로봇 제어 API 공개…시간당 3달러
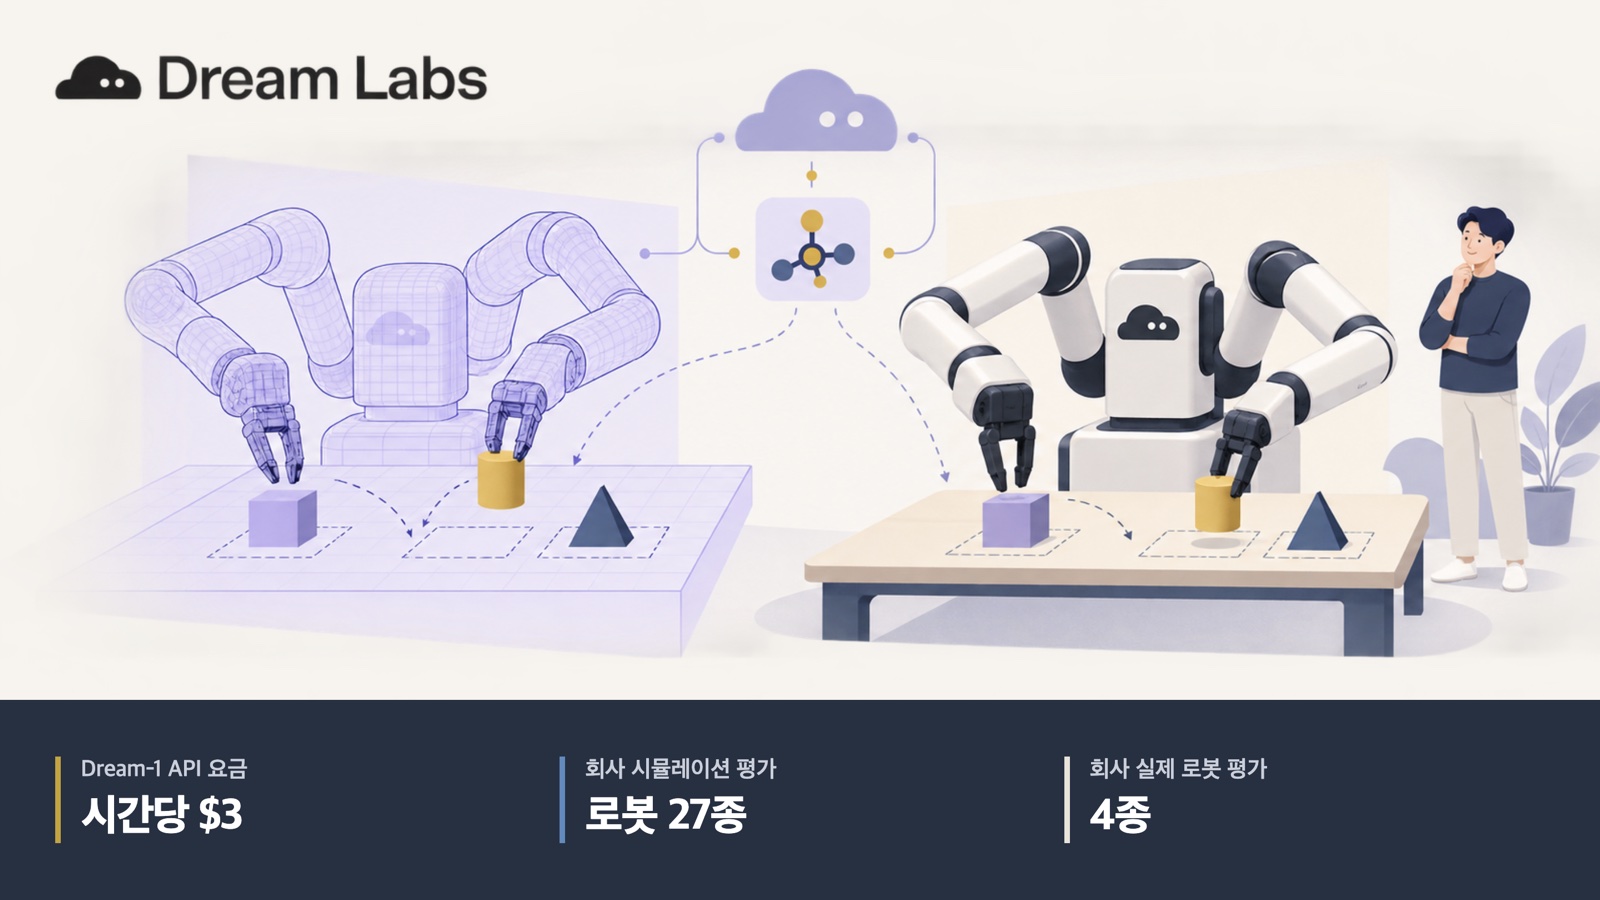
드림랩스(Dream Labs)는 한국 시각 10월 20일 공식 발표에서 로봇 행동 모델 드림-1(Dream-1)과 공개 API를 내놓았다. 학습에서 보지 못한 로봇·작업·환경으로의 확장을 목표로 하며, 대상은 두 팔과 평행 집게를 갖춘 로봇이다. 이번에는 25일 밤 재소개를 계기로 회사 자료와 외부 평가를 대조했다.
- 범위: 회사는 처음 보는 로봇 27종의 시뮬레이션과 실제 로봇 4종을 평가했다.
- 가격: Dream-1은 시간당 3달러, 가벼운 Dream-1-flash는 2달러다.
- 외부 평가: Robocurve의 로봇 과제 평균 점수는 Dream-1 59.3%, Gemini 4 Argon 48.2%다.
무엇이 달라지나
로봇마다 처음부터 시범 데이터를 모아 모델을 만드는 방식 외에, 공통 모델을 연결해 전이 성능부터 확인하는 선택지가 생겼다. 이미 양팔 로봇을 보유한 연구팀은 추가 학습 전 성능과 추가 학습 뒤 성능을 나눠 비용을 비교할 수 있다.
한계
연구용 베타이며 안전이 중요한 현장용으로 검증된 제품이 아니다. 27종은 시뮬레이션 대상이고 실제 로봇 27종 실험이 아니다. 외부 평균 점수는 모든 과제의 완전 성공률이 아니며, 로봇의 역기구학 해법·작업 공간에 따라 성능이 달라진다. 로봇 장비·통신·사람의 감독 비용은 API 요금과 별개다.
자료
- Dream-1 공식 연구 소개: 로봇 범위, 모델 요금과 연구 베타 조건.
- 공식 제공 발표: 20일 KST 공개 API 안내.
- Robocurve 외부 평가: 과제 점수·시도당 비용·시간의 비교 조건.
본문 펼치기 · 약 2분
벤치마크·비교
Robocurve는 RoboDojo-RC Tier 1에서 모델 설정마다 120번 시도했다. 언어 모델은 최대 40회 호출, 행동 모델은 최대 3,600회 제어 단계라는 서로 다른 상한을 적용한다. 현재 표의 Dream-1 평균 점수는 59.3%, 시도당 추론 비용은 0.15달러이며, Gemini 4 Argon은 48.2%·2.34달러다.
두 모델의 표시 비용을 나누면 약 15.6배다. 이는 해당 평가의 비용 차이로, 모든 로봇 작업의 절감률을 뜻하지 않는다. 같은 표에서 더 싼 GR00T N1.7은 0.05달러·9.5%, MolmoAct2는 0.07달러·18.9%여서 최저 비용과 최고 점수는 별개의 선택 기준이다.
가격·조건
회사 요금 설명은 한 번 호출할 때 1.6초 분량의 행동을 반환하며 한 시간에 2,250회 호출한다고 적었다. 이 기준으로 Dream-1은 호출당 약 0.0013달러, Flash는 약 0.0009달러다. 하루 3시간씩 20일, 총 60시간의 행동을 요청한다고 가정하면 표시 요율의 단순 합계는 각각 180달러와 120달러다. 실제 작업의 대기·재시도와 감독 비용은 이 계산에 넣지 않았다.
외부 평가의 59.3%는 Dream-1에 붙은 값이다. 저렴한 Flash를 같은 점수로 놓고 예산을 계산하지 않았다. 예산표에는 사용할 모델과 목표 작업, 필요한 행동 시간, 사람이 개입한 시간을 함께 기록하면 두 요금의 의미가 분명해진다.
궁금한 것
Q. 어떤 로봇이 대상이야? 공식 설명의 현재 대상은 양팔·평행 집게 로봇이다. 손끝이 갈 위치를 예측하는 방식에서는 각 로봇의 역기구학 해법이 실제 움직임을 담당한다.
Q. 27종 모두 실제 로봇이야? 실험 구성은 시뮬레이션 27종과 실제 로봇 4종이다. 기준 로봇 YAM 대비 성능으로 비교했으며 실제 로봇에는 해당 로봇으로 학습하기 전 체크포인트를 썼다.
Q. 더 싼 모델도 있어? 가격표의 Dream-1-flash는 시간당 2달러다. Dream-1의 3달러와 구분해 소개하며, 둘의 선택은 내 작업에서 얻는 결과와 함께 비교할 항목이다.
앤트그룹, Ming-3.0 음성 모델 공개…한국어 포함 7개 언어
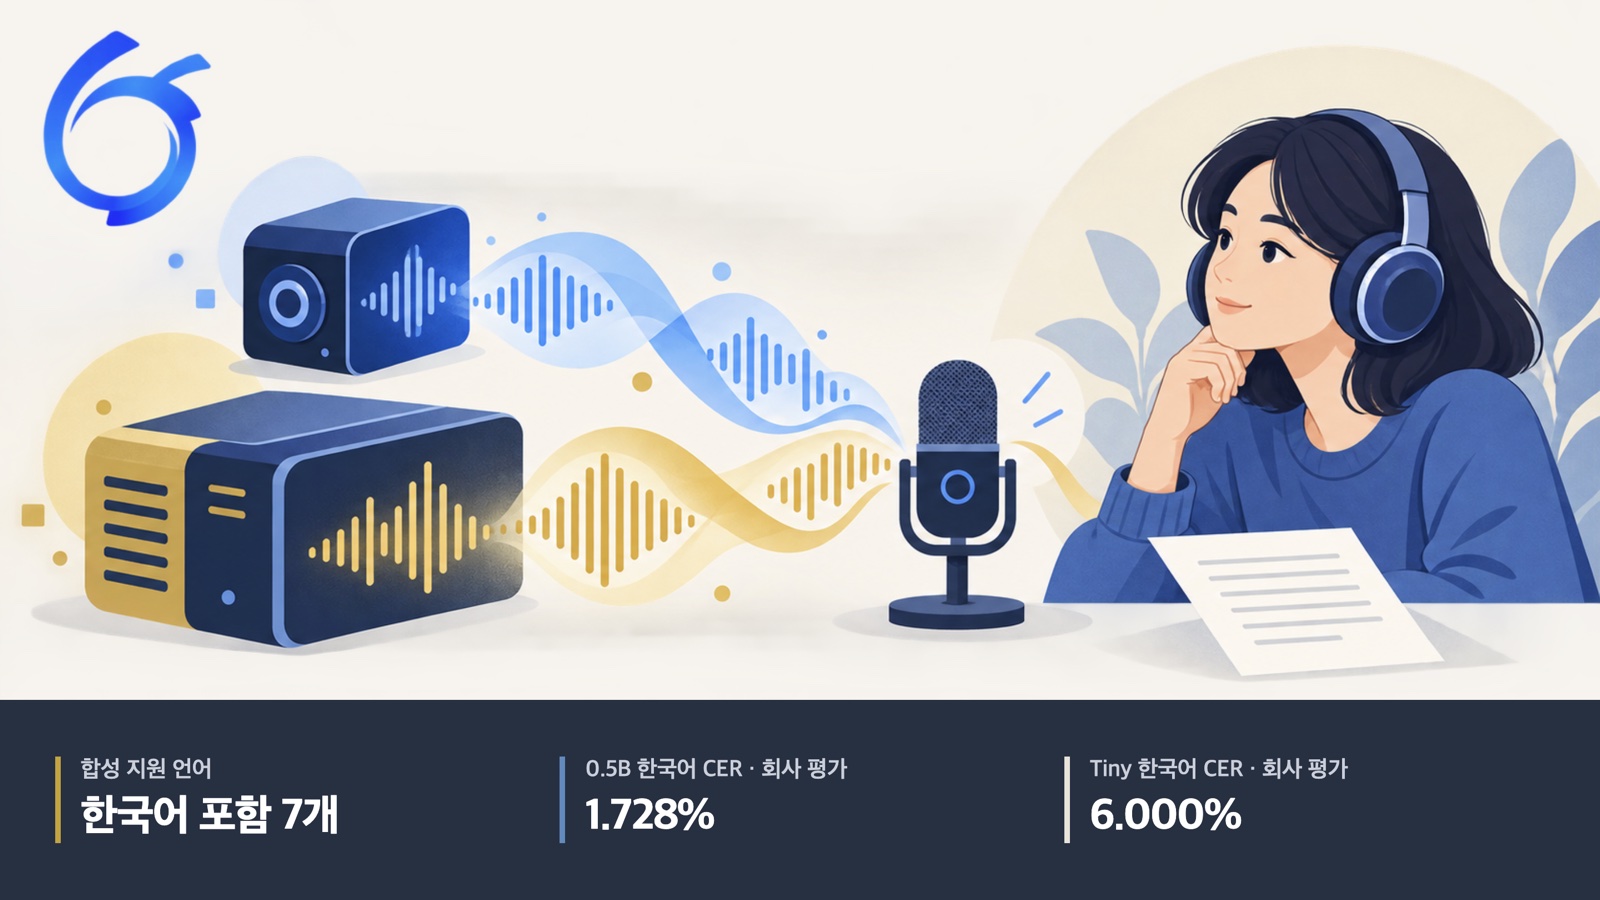
앤트그룹(Ant Group)의 인클루전AI(inclusionAI)가 공개한 밍-3.0(Ming-3.0) 음성 모델군에는 합성·이해·인식 모델 다섯 종이 포함된다. 그중 Ming-3.0-tts는 한국어를 포함한 7개 언어를 합성하는 두 버전을 제공한다. 저장소의 최초 배포 커밋은 10월 19일이며, 25일 밤 한국어 주간 정리에서 다시 소개됐다.
- 구성: 5억 매개변수의 0.5B와 전체 79억·토큰당 활성 13억인 Tiny가 있다.
- 한국어: 회사 평가의 문자 오류율은 0.5B 1.728%, Tiny 6.000%다.
- 권리: TTS 실행 코드와 모델 카드는 MIT 라이선스를 안내한다.
무엇이 달라지나
한국어 합성을 포함한 공개 음성 제작 도구를 비교할 선택지가 늘었다. 모델 이름에 붙은 Tiny보다 실제 매개변수 수와 한국어 평가를 먼저 보면, 더 큰 모델을 고르는 일이 곧 정확도 향상으로 이어지지 않는다는 차이가 드러난다.
한계
오류율은 제작진의 자동 음성인식 기반 평가이며 자연스러움·감정 표현의 종합 점수가 아니다. 웃음·한숨 등 14개 효과 태그는 중국어·영어로 안내되고 한국어 합성은 별도 작업 경로다. 공식 검증·권장 장비는 H800·H20급이며 개인 PC의 최소 메모리와 한국어 효과 태그 품질은 확립되지 않았다. 타인의 목소리 복제에는 동의와 권리 확인이 필요하다.
자료
- 공식 TTS 코드·비교표: 두 버전, 언어별 평가, 실행 환경.
- Tiny 모델 카드: 7개 언어, 작업별 입력, 한국어 약점.
- Ming-3.0 모델 모음: 합성·이해·인식 다섯 모델.
본문 펼치기 · 약 2분
벤치마크·비교
제작진의 다국어 표는 MiniMax 다국어 시험 자료에서 모델별 권장 추론 설정과 통일된 자동 음성인식 프로토콜을 사용했다. 한국어 문자 오류율은 낮을수록 좋은 지표다. Ming 0.5B의 1.728%는 Tiny의 6.000%보다 낮고, 같은 표의 파이어레드(FireRedTTS3)는 1.644%다.
한국어 나레이션을 비교한다면 더 큰 Tiny를 자동으로 우선할 이유는 없다. 반대로 같은 표의 독일어 단어 오류율은 Tiny 0.325%·0.5B 0.365%, 스페인어는 0.971%·1.099%로 Tiny가 더 낮다. 언어별로 결과가 달라, 한국어 정확도와 다른 언어 성능을 분리해 후보를 고를 수 있다.
활용·적용
공식 작업 표는 한국어를 다국어 합성 경로에 넣는다. 참고 음성과 해당 음성의 글, 목표 언어를 입력한다. 중국어·영어 효과 태그를 쓰는 경로, 감정 조절 경로, 다중 화자 팟캐스트 경로는 입력 형식이 서로 다르다. 여러 기능을 한 요청에 모두 섞는 설계보다 작업별 예제를 기준으로 시험 항목을 나누기 좋다.
저장소는 0.5B 환경을 H800 80GB와 H20 96GB에서 시험했으며, Tiny에는 별도 의존성과 H800 추론을 권장한다. MIT로 제공되는 코드·가중치 사용권과 실제 GPU 운영비는 별개의 항목이다. 짧은 문장·숫자·고유명사·긴 문장을 각각 비교하면 한국어 제작 업무에 필요한 검수량을 판단할 수 있다.
궁금한 것
Q. Tiny가 0.5B보다 작아? 공식 모델 구성은 0.5B가 5억 개의 밀집형 모델이고, Tiny는 전체 79억 개 중 약 13억 개를 활성화하는 모델이라고 구분한다.
Q. 한국어가 지원 언어에 들어가? Tiny 카드는 중국어·영어·독일어·스페인어·프랑스어·한국어·일본어를 명시한다. 한국어는 다국어 합성 작업으로 안내한다.
Q. 음성 합성 모델만 공개됐어? 공식 모음에는 TTS 두 종 외에 audio-flash·audio-tiny·asr-tiny가 들어 있다. 이 소식의 한국어 오류율 비교는 TTS 두 종에 관한 것이다.
Grok Bot, 휴대폰 앱 연결…캘린더·알림·연락처 사용
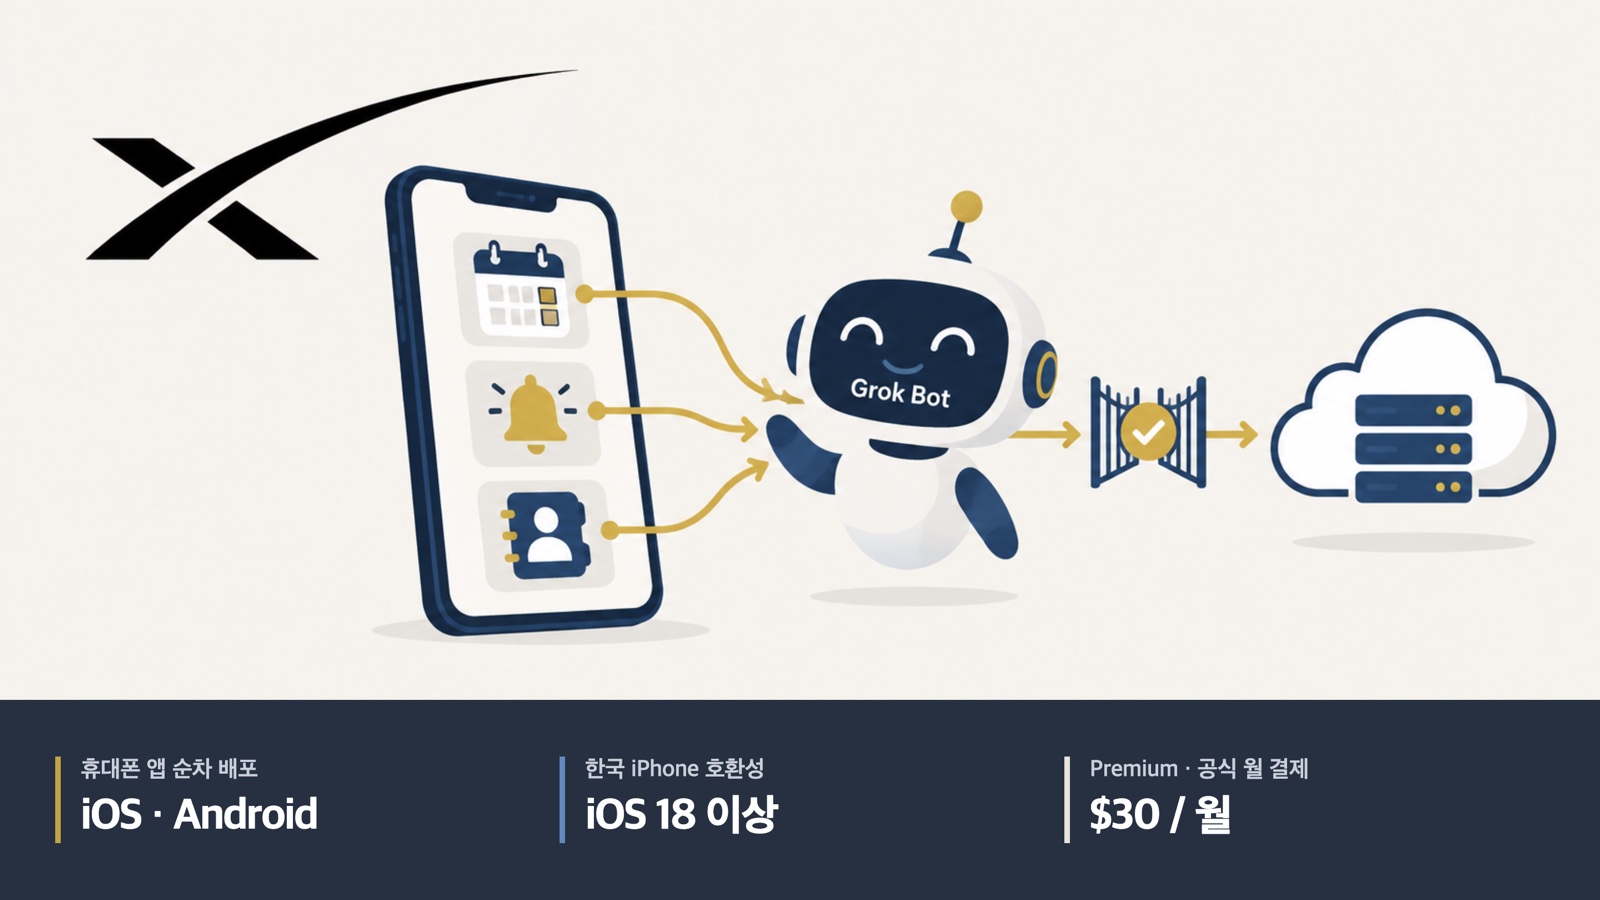
그록 봇(Grok Bot)은 10월 23일 공식 계정에서 휴대폰의 캘린더·알림·연락처 등 앱을 사용할 수 있게 됐다고 발표했다. iOS와 안드로이드에 순차 배포하는 기능이다. 웹사이트에서 작업하는 기존 에이전트에 휴대폰 앱 연결이 더해졌으며, 로그인 정보·카드를 저장하는 Vault 발표와는 별개다.
- 연결: 공식 발표가 예로 든 앱은 캘린더·알림·연락처다.
- 국내: 한국 앱스토어에 공식 앱이 올라 있으며 한국어 외 11개 언어, iOS 18 이상을 표시한다.
- 요금: 공식 웹의 개인 월간 요금은 Premium 30달러·Super 100달러·Ultra 200달러다.
무엇이 달라지나
웹 도구에만 흩어져 있던 업무와 휴대폰의 일정·연락처를 같은 에이전트의 작업 흐름으로 연결할 수 있게 된다. 국내 iPhone 사용자는 앱스토어의 제공자·호환성부터 대조할 수 있으며, 팀은 앱 연결과 실제 행동 승인 범위를 함께 설계할 필요가 있다.
한계
한국 스토어의 무료 표시는 다운로드 가격이며 작업 사용량이 무제한이라는 뜻이 아니다. 계정별 새 기능 활성화와 안드로이드 한국 스토어 조건은 직접 시험하지 않았다. 앱 개인정보 표시는 개발자의 신고이며 보안 감사 결과가 아니고, 암호화·승인 기능 역시 회사 설명이다. 연락처·일정의 조직 내 공유 권한은 별도 검토 대상이다.
자료
- 휴대폰 앱 연결 공식 발표: 연결 대상과 iOS·안드로이드 순차 배포.
- Grok Bot 공식 제품·요금: 개인 요금과 기존 구독 포함 조건, 개인정보 FAQ.
- 한국 App Store 공식 앱: 제공자 X Corp., 언어·기기·개인정보 표시.
본문 펼치기 · 약 2분
가격·조건
공식 개인 요금은 월 결제 기준 Premium 30달러, Super 100달러, Ultra 200달러다. Super는 Premium 사용량의 3.5배, Ultra는 12배로 안내한다. 이미 해당 개인·팀·기업 요금제를 쓰는 고객에게 포함된다는 설명도 있어 기존 구독의 대상 여부를 확인하는 순서가 맞다.
한국 스토어는 무료 다운로드와 앱 내 구입, 만 19세 이상, iOS 18 이상을 표시한다. 공식 웹의 달러 요금과 한국 앱 내 결제액은 같은 표시가 아니므로 원화 청구액으로 바꿔 적지 않았다. 한국어 지원은 앱의 언어 항목이며, 모든 한국어 업무의 처리 정확도를 뜻하는 성능 점수는 아니다.
활용·적용
공식 제품 설명은 봇마다 자체 컴퓨터가 있고 여러 작업을 병렬로 진행한다고 안내한다. 이번 휴대폰 기능 발표는 그 컴퓨터의 웹 작업과 휴대폰 앱 접근을 잇는 변경이다. 단순히 대화에서 일정 내용을 설명하는 기능과 실제 앱을 사용하는 기능을 구분할 지점이다.
한국 앱 개인정보 표시는 연락처 정보·사용자 콘텐츠·식별자·사용 데이터·진단 정보가 신원에 연결될 수 있다고 적었다. 공식 FAQ는 학습 제외 선택과 민감한 행동의 Auto Review를 설명한다. 조직 도입에서는 저장할 정보, 연결할 앱, 사람의 승인을 거칠 행동을 각각 정해 두면 권한 검토가 구체적이 된다.
궁금한 것
Q. 한국 iPhone에서 찾을 수 있어? 한국 App Store에 앱 ID 6794501026의 Grok Bot이 표시되며 제공자는 X Corp.다. 표시된 호환성은 iOS 18 이상이다.
Q. 어떤 앱을 연결해? 공식 발표는 캘린더·알림·연락처와 그 밖의 앱을 예로 든다. 해당 글에서 전체 앱 목록을 열거하지는 않았다.
Q. 기존 유료 구독에 포함돼? 제품 페이지는 Premium·Super·Ultra·Teams·Enterprise에 포함된다고 안내한다. 개인 월간 표시 요금과 사용량 배수는 요금 칸에서 각각 구분한다.
Nous, 허미스 모바일 앱 예고…공식 앱은 아직 미출시
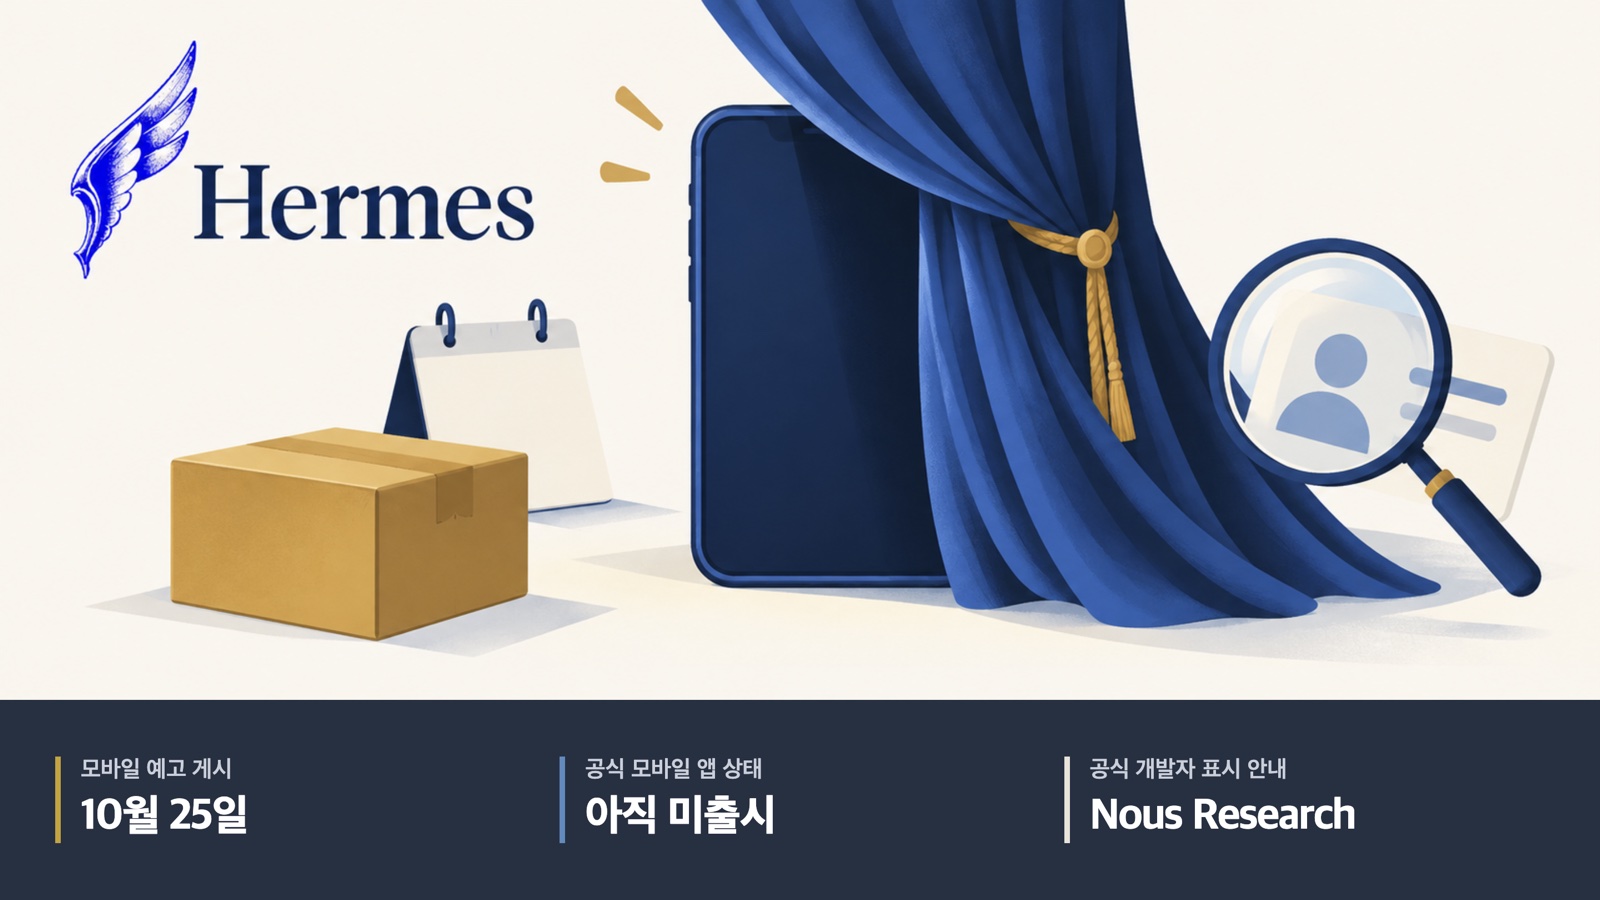
누스 리서치(Nous Research)는 10월 25일 공식 계정에 허미스(Hermes) 모바일 앱을 암시하는 이미지를 공개했다. 이어 공식 후속 글에서 자사의 모바일 앱은 아직 앱스토어에 없다고 밝혔다. 공개된 상태는 배포 완료가 아니라 예고다.
- 단계: 모바일 화면 예고와 실제 앱스토어 출시를 구분했다.
- 공식 답변: 향후 App Store 개발자가 Nous Research로 표시되는지 묻는 질문에 회사는 “Yes”라고 답했다.
- 비교: Grok Bot은 한국 스토어에 공식 앱이 있지만 Hermes는 회사가 아직 미출시로 안내한다.
무엇이 달라지나
허미스는 모바일 화면을 예고했고, 그록 봇은 실제 스토어의 제공 조건을 비교할 수 있는 상태다. 지금은 기능 수를 비교하기보다 실제 배포된 앱과 예고 화면을 나눠 보는 것이 유용하다.
한계
출시일·요금·지원 운영체제·한국어와 한국 배포 조건은 확인되지 않았다. 회사는 Hermes 브랜드를 밀접하게 모방한 앱을 사칭 위험으로 지적했으며 모든 제3자 프로젝트를 같은 것으로 규정하지는 않았다. 예고 이미지에서 상세 기능이나 배포 완료를 추정하지 않았고 앱을 설치하지 않았다.
자료
- Nous 공식 모바일 예고: 25일 공개된 이미지 게시물.
- 공식 앱 미출시 안내: 앱스토어 상태와 유사 브랜드 앱 안내.
- 개발자 표시 관련 공식 답변: 실제 독자 질문에 대한 회사 답변.
본문 펼치기 · 약 2분
벤치마크·비교
이미 배포된 Grok Bot은 한국 스토어에서 개발자·언어·iOS 최소 버전·개인정보 표시를 확인할 수 있다. 반면 Nous의 현재 안내는 공식 모바일 앱이 아직 스토어에 없다는 것이다. 이 비교는 모델 성능 순위가 아니라 제품 제공 단계의 비교다.
따라서 모바일 에이전트 도입 일정은 두 제품을 같은 시작선에 놓지 않는 편이 낫다. Grok Bot은 현재 스토어의 기기·구독 조건을 대조할 단계이고, Hermes는 공식 출시 안내가 나올 때 배포 주소와 조건을 확인할 단계다. 예고 화면만으로 기능 시험이나 비용 비교를 대신할 수는 없다.
활용·적용
실제 독자는 App Store의 개발자가 Nous Research인지를 물었다. 회사는 그렇다고 답했다. 회사가 안내한 개발자 표시와 공식 계정에서 직접 연결하는 배포 주소를 함께 대조하는 방식은 이름과 아이콘만 보는 것보다 구체적인 확인 기준이다.
공식 후속 안내는 정당한 커뮤니티 프로젝트와 Hermes 브랜드를 밀접하게 흉내 낸 앱을 구분한다. 제3자라는 이유만으로 전부 같은 앱으로 묶지 말고, 누가 개발했는지와 공식 제품을 자처하는지를 따로 읽을 필요가 있다. 현재는 설치 대신 출시 공지와 개발자 정보를 기다릴 수 있다.
궁금한 것
Q. 공식 App Store 개발자 이름은 Nous Research가 되는 거야? 이 실제 질문에 공식 계정은 “Yes”라고 답했다. 향후 출시 때 배포 링크와 함께 대조할 회사 안내다.
Q. 이미 나온 정식 모바일 앱이야? 공식 후속 글의 현재 단계는 미출시다. 예고 게시물과 앱 다운로드 가능 상태는 별개다.
Q. 지금 비교할 수 있는 조건은 뭐야? Nous의 제공 단계와 Grok Bot의 실제 스토어 조건을 나눠 비교할 수 있다. Hermes의 세부 요금표를 다른 제품 요금으로 대신 채우지 않았다.
이미지와 정정: AI 일러스트는 실제 제품·실험 화면이 아니다. 정정·문의는 문의 페이지로 받는다.
자료 확인: 2026년 10월 26일 KST, 0시 회차. 공식 코드·모델 카드·제품·스토어와 외부 평가를 대조한 공개 자료 종합이며 직접 실행·성능 재현은 하지 않았다. Hermes의 개발자 질문은 실제 게시물, 나머지는 기본 질문을 썼다. 소셜 표본은 대표 여론이 아니다.