Google과 XREAL이 XREAL AURA 주문을 10월 28일 미국, 캐나다, 한국에서 열었습니다. OpenAI는 자격을 갖춘 ChatGPT Pro와 Business 구독자가 월 API 크레딧을 신청할 수 있게 했습니다. GitHub는 Universe에서 Copilot Fusion과 Projects를 내놓았고, OpenAI의 dot은 미국 Pro 사용자에게 문자 기능을 열었습니다. Cartesia의 토큰화 없는 H-Net 연구 결과까지 다섯 소식에서 무엇이 확인됐고 무엇이 회사 설명인지 함께 살펴봅니다.
오늘 담긴 것
- Google·XREAL, XREAL AURA 한국 주문 시작…출시 가격 최저 1,099달러(연말까지): Google의 제품 출시 발표
- OpenAI, ChatGPT Pro·Business API 크레딧 신청 시작…Pro 월 100~500달러: OpenAI의 개발자 커뮤니티 공지
- GitHub, Copilot Fusion·Projects·보안 확장 발표…Fusion Max 비용 절반은 GitHub 주장: GitHub의 Universe 발표
- OpenAI, ChatGPT dot에 iMessage·RCS 문자 지원…미국 Pro 베타 한정: OpenAI의 기능 안내
- Cartesia, 토큰 없는 H-Net 연구 공개…2단 H-Net은 연산·데이터 10배 절감 주장: Cartesia의 연구 글
XR 기기
Google·XREAL, XREAL AURA 한국 주문 시작…출시 가격 최저 1,099달러(연말까지)
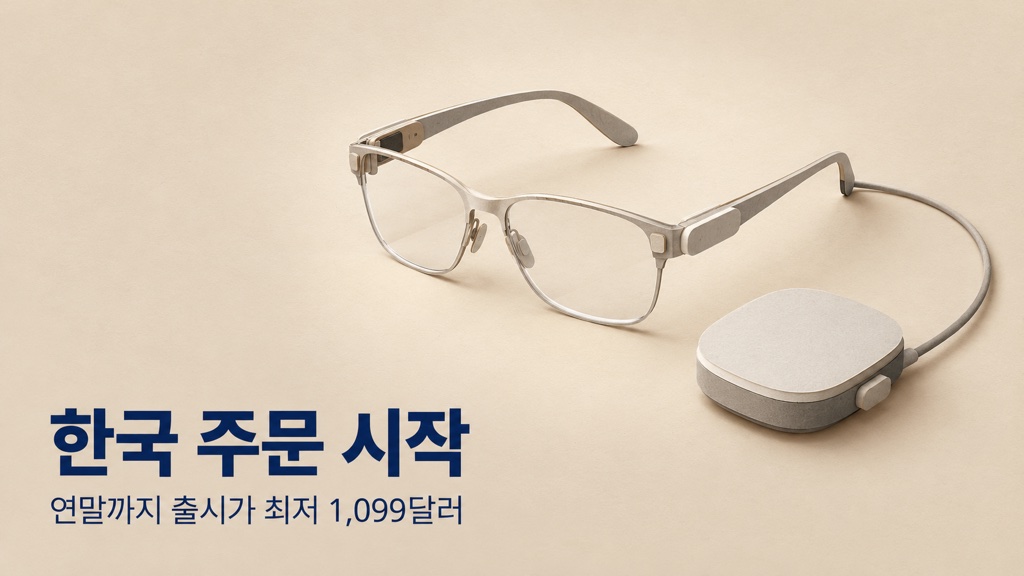
Google이 10월 28일 XREAL과 함께 XREAL AURA를 출시했다고 밝혔다. Android XR로 구동되는 첫 유선 XR 안경이며, 18세 이상 사용자는 미국, 캐나다, 한국에서 이날부터 주문할 수 있고 일본은 11월 2일부터다.
- 가격: 출시 가격은 연말까지 1,099달러(USD)부터이며, 한국 원화 가격은 Google 글에 나오지 않는다. 주문은 xreal.com/aura, 미국은 BestBuy.com에서도 받는다.
- 구성: 안경은 95g 미만이고 연산은 케이블로 연결한 컴퓨트 퍽이 맡는다. 시야각은 70도.
- Gemini: 노트북 창(Wired Mirroring)을 포함해 시야에 보이는 대상 전반에서 작동한다고 Google은 설명한다.
무엇이 달라지나
칩과 배터리를 퍽으로 옮겨 안경을 가볍게 만든 대신 케이블 연결을 받아들이는 구조다. USB-C 영상 출력 케이블로 노트북을 꽂으면 화면이 크기 조절이 가능한 창으로 뜨고, 따로 설치할 소프트웨어는 없다고 Google은 밝혔다.
한계
한국 원화 가격과 한국 배송 시기는 Google 글에 적혀 있지 않다. 미국 BestBuy 배송은 11월 중순부터라고만 나온다. 1,099달러가 어떤 메모리와 저장 용량 구성의 가격인지, 연말 이후 가격이 얼마인지, 디스플레이 해상도와 배터리 사용 시간은 이 글에 적혀 있지 않다. 착용감과 Gemini 기능의 실제 동작은 Google의 설명이며 직접 써 본 결과가 아니다.
커뮤니티 반응
■안경의 해상도가 얼마인지 묻는 답글이 달렸다.
■칩과 배터리를 케이블 달린 퍽에 넣어 95g 아래를 지킨 선택이 좋은 타협인지 치명적인 단점인지 묻는 글이 나왔다.
■창립자 우선 구매권 보유자는 완납 시점에 따라 11월 중순 첫 배송분과 그다음 배송분으로 갈린다는 안내가 올라왔다.
본문 펼치기 · 약 3분
안경 무게를 95g 아래로 낮추려고 칩과 배터리를 케이블 너머 퍽에 옮겼다
Google 글에 따르면 AURA의 안경은 95g 미만이다. 무거운 연산은 케이블로 연결한 휴대용 컴퓨트 퍽이 맡고, 퍽 안에 배터리와 Qualcomm의 새 Snapdragon Reality Elite 플랫폼이 들어 있다. 이 플랫폼은 AURA에서 처음 선보인다. 렌즈는 투명해서 현실을 눈으로 보면서 공간 콘텐츠를 시야에 투사하고, 시야각은 70도다.
이 구조는 가벼움을 얻는 대신 선을 달고 다니는 조건을 받아들이는 선택이다. Google 글에는 퍽의 크기와 무게, 배터리 용량과 사용 시간, 디스플레이 해상도 수치가 없다. 착용감과 휴대성은 숫자로 비교하기 어려우므로 구매 전에 이 항목이 공개되는지 보는 편이 안전하다. Google Play 앱과 XR용으로 만든 150개 이상의 앱을 쓸 수 있다고 Google 글은 설명한다.
노트북 연결과 Gemini 시야 공유는 오늘부터 쓸 수 있다고 소개된다
Wired Mirroring은 영상 출력을 지원하는 USB-C 케이블로 노트북을 AURA에 연결하는 방식이다. 노트북 화면이 창 하나로 나타나 크기를 바꾸고 원하는 곳에 둘 수 있으며, 블루투스 키보드와 마우스를 연결하거나 퍽을 트랙패드로 쓸 수 있다고 Google 글은 설명한다. 영상 출력을 지원하지 않는 케이블은 이 기능의 조건에 맞지 않는다.
Gemini는 노트북 창을 포함해 시야에 보이는 것에서 작동한다고 한다. 오늘부터는 시야를 공유하면 Gemini가 방 안이나 화면에서 집중할 곳을 강조해 보여 줄 수 있다고 Google은 밝혔다. 화면이 착용자에게만 보이므로 공공장소에서도 기밀 문서를 열 수 있다는 설명은 Google의 주장이다.
콘텐츠는 오늘 나온 것과 앞으로 나올 것이 섞여 있다
AURA와 함께 오늘 도착하는 XR용 영화와 공연으로 Nevatars, Galapagos: the Last Eden, 샌프란시스코 발레단의 Nutcracker가 소개됐다. 신작 XR 게임으로는 Fallout Factions와 Project Hail Mary: Journey Among the Stars가 AURA와 함께 나온다고 적혔지만 구체적인 출시일은 글에 없다.
Google Photos의 공간 갤러리는 올해 안에 포함된다는 예정 기능이다. 지금 쓸 수 있는 기능과 예정 기능을 구분해 구매 이유를 따져야 한다. 기업용 대량 도입은 Android Enterprise 블로그에서 확인하라고 Google 글은 안내한다.
주문 조건은 나이와 지역, 그리고 연말까지라는 가격 기한으로 갈린다
Google 글에 따르면 AURA는 18세 이상 사용자가 10월 28일부터 미국, 캐나다, 한국에서 주문할 수 있고 일본은 11월 2일부터 주문을 받는다. 출시 가격은 연말까지 1,099달러(USD)부터이며 주문은 xreal.com/aura에서 하고, 미국에서는 BestBuy.com에서도 받는다.
여기서 가격은 달러로 적힌 출시 가격이고 연말까지라는 기한이 붙어 있다. 한국 원화 가격과 한국 배송 시기는 글에 나오지 않고, BestBuy 배송은 11월 중순부터라고만 적혀 있다. 한국 구매자는 주문 단계에 표시되는 결제 금액과 배송 일정을 따로 확인해야 한다.
자세히 읽기 · Google의 XREAL AURA 출시 글 ↗
개발자 도구와 구독
OpenAI, ChatGPT Pro·Business API 크레딧 신청 시작…Pro 월 100~500달러
OpenAI 개발자 커뮤니티가 10월 29일 공지 글에서 ChatGPT Pro와 Business 구독으로 월 API 크레딧을 받을 수 있다고 안내했다. 신청은 ChatGPT 결제 설정에서 하고, API 키는 ChatGPT나 Codex의 OpenAI Developers 플러그인으로 만든다.
- Pro: 등급에 따라 월 100달러, 200달러, 500달러.
- Business: 유료 Standard 좌석당 20달러, 유료 Premium 좌석당 100달러. 워크스페이스당 합산 최대 500달러.
- 신청: chatgpt.com/settings/billing에서 청구.
무엇이 달라지나
ChatGPT 구독료에 더해 API 테스트에 쓸 수 있는 월 예산이 생긴다. 구독을 이미 쓰는 개인과 팀은 별도 API 결제 없이 앱과 에이전트를 시험해 볼 수 있는 구조가 된다.
한계
첫 지급이 남은 청구 기간만큼 일할 계산되고 월 크레딧이 구독 청구 주기 끝에 소멸하며 이월되지 않는다는 내용은 같은 글 댓글에서 일반 사용자가 쓴 것이다. 공지 게시자가 바로 뒤에 “That’s correct”라고 답했지만 덧붙인 것은 매달 받을 수 있다는 점뿐이라 세 조건을 모두 확인한 것인지는 알 수 없고, OpenAI 도움말로도 확인하지 못했다. 공지가 링크한 도움말 문서의 자격 요건과 활성화 조건은 이번 확인 범위 밖이다. Pro의 100달러, 200달러, 500달러 등급이 각각 어느 요금제인지, 한국 구독자가 대상인지는 공지에 적혀 있지 않다.
커뮤니티 반응
■단계적으로 풀리는 것 같다며 Pro 구독인데도 아직 크레딧이 보이지 않는다는 글이 이어졌다.
■두 계정 중 Apple로 결제한 계정에는 크레딧이 없다는 후기가 나왔다.
■100달러 등급이 첫 달에는 남은 청구 기간만큼 일할 계산돼 71달러로 들어왔고 다음 주기부터 100달러라는 후기도 올라왔다.
본문 펼치기 · 약 3분
신청은 결제 설정에서 시작하고 API 키는 별도 플러그인으로 만든다
공지 글이 안내하는 순서는 두 단계다. 먼저 ChatGPT 결제 설정에서 API 크레딧을 청구하고, 그다음 ChatGPT나 Codex에서 OpenAI Developers 플러그인을 사용해 API 키를 만들어 프로젝트를 시작한다.
이 경로는 공지가 제시한 시작 방법이며 자격 조건의 전부는 아니다. 공지는 크레딧 금액이 플랜에 따라 다르다고만 하고, 자격과 활성화 조건은 도움말 문서에 있다고 링크한다. 같은 글의 댓글에는 구독 로그인이 API 조직의 소유 권한을 가져야 할 수 있다는 추측이 있지만 공식 확인은 아니다.
금액은 등급과 좌석 수로 정해지고 Business는 합산 상한이 있다
공지 글에 따르면 Pro는 등급에 따라 월 100달러, 200달러, 500달러를 받는다. Business는 유료 Standard 좌석 하나당 20달러, 유료 Premium 좌석 하나당 100달러를 받고, 한 워크스페이스에서 합산해 최대 500달러까지 모인다. 상한이 있으므로 좌석이 많아도 월 500달러를 넘지 않는다.
예를 들어 유료 Standard 좌석이 10개인 워크스페이스는 공지의 단가에 좌석 수만 곱하면 200달러가 된다. 이 계산은 공지의 단가에 가정을 얹은 것이고, 실제 지급액은 청구 상태에 따라 달라질 수 있다.
지급 방식의 세부는 공식 문서로 확인하기 전까지 가정으로 두는 편이 맞다
월 지급이라는 점은 공지 글 게시자가 댓글에서 한 번만이 아니라 매달 받을 수 있다고 확인했다. 한편 일반 사용자의 답글은 첫 지급이 남은 결제 기간만큼 일할 계산되고, 월 크레딧은 구독 청구 주기 끝에 소멸하며 이월되지 않는다고 설명했다. 게시자는 이 답글 바로 뒤에 “That’s correct”라고 답하며 매달 받을 수 있다는 점을 덧붙였지만, 이 확인이 일할 계산·소멸·이월 없음 모두에 해당하는지는 글에 나와 있지 않다. 팀 예산에 넣을 때는 이 세 가지를 OpenAI 도움말로 확인되기 전까지 가정으로 두고, 도움말 문서를 따로 읽어 보는 편이 맞다.
공지에는 한국을 포함한 지원 지역과 Pro 등급의 정의가 없다. 100달러, 200달러, 500달러가 각각 어느 요금제에 대응하는지도 적혀 있지 않다. 크레딧이 보이지 않는다는 사용자 보고도 있어서, 단계적으로 제공되는지 여부는 OpenAI의 공식 설명이 필요한 부분이다.
공지가 링크한 도움말은 자격, 활성화, 구독 변경을 다룬다고 소개된다
공지는 OpenAI 도움말의 API credits benefit for eligible ChatGPT subscriptions 문서를 링크하고, 자격, 활성화, 월 지급, API 사용, 청구, 구독 변경을 다루는 문서라고 소개한다. 이번에는 이 도움말 문서를 열어 보지 못해서 구체적인 조건은 확인하지 못했다.
그래서 구독 등급을 바꾸거나 해지할 때 크레딧이 어떻게 되는지, 결제 수단에 따라 청구 가능 여부가 달라지는지는 이 글에서 답할 수 없다. 팀에서 크레딧을 개발 예산에 넣으려면 도움말의 자격과 구독 변경 항목을 먼저 읽고, 실제로 청구 화면에 금액이 보이는지 한 번 확인한 뒤 쓰는 순서가 안전하다.
자세히 읽기 · OpenAI 개발자 커뮤니티의 API 크레딧 공지 ↗
GitHub, Copilot Fusion·Projects·보안 확장 발표…Fusion Max 비용 절반은 GitHub 주장
GitHub가 10월 28일 Universe에서 Copilot app 중심의 새 기능들을 발표했다. 같은 날 보안 확장의 공개 미리보기도 알렸고, Projects는 문서로 사용법이 올라왔다.
- Fusion: 작업이 필요로 하는 추론, 코드 생성, 디버깅, 도구 사용을 판단해 하나 이상의 모델에서 실행 방식을 고른다. Artificial Analysis Coding Agent Index에서 Fusion Max가 Opus 5.5 Max와 2점 이내, 비용 절반, 작업당 시간 40% 감소라고 GitHub가 밝혔다.
- Projects: Copilot app에서 오늘부터, 여러 저장소에 걸친 에이전트 작업을 관리형 병렬 세션으로 돌린다. 공개 미리보기이며 모든 Copilot 플랜에서 쓸 수 있다.
- 보안 확장: 공개 미리보기. code scanning 알림을 앱 안에서 보고 Explain이나 Fix를 요청한다. GitHub Enterprise Server는 미지원.
무엇이 달라지나
모델 선택을 사용자가 일일이 하지 않고 Fusion이 작업에 맞춰 고르는 방식이 추가된다. GitHub Enterprise 고객은 별도 구독 없이 Copilot 기능을 쓰고 사용한 AI 크레딧만 낸다. 지금은 GitHub Sales를 통해 가능하고 셀프서비스는 곧 제공될 예정이다.
한계
Fusion Max의 2점 차, 비용 절반, 시간 40% 감소는 GitHub가 블로그에서 밝힌 수치다. 블로그 글에는 지수의 척도와 점수 자체, 평가한 작업 구성, 비용을 재는 단위, 40% 감소의 비교 기준이 적혀 있지 않다. Fusion의 제공 시점과 대상 플랜은 이 글에서 밝히지 않았고, 한국 제공 여부도 확인한 자료에 없다. 같은 날 changelog 목록에 Fusion 항목이 있으나 내용은 이번 확인 범위에 들지 않았다.
커뮤니티 반응
■에이전트가 백그라운드에서 무엇을 하는지 놓치기 쉬워서, 모델 조합보다 현황을 한곳에 모아 보는 Projects가 더 눈에 띈다는 글이 올라왔다.
■Fusion이 로컬 모델로도 라우팅할 수 있지만 실험 단계이고 변경 기록상 라우팅 판단은 여전히 클라우드에서 이뤄진다는 지적이 나왔다.
■Fusion이 어떤 모델이 어떤 변경을 썼는지 보여 주는지 묻는 질문이 달렸다.
본문 펼치기 · 약 3분
Fusion Max의 비용 절반 수치는 GitHub가 인용한 지수 기준이다
GitHub 블로그에 따르면 Copilot Fusion은 작업에 필요한 능력을 판단한 뒤 하나 이상의 모델에서 어떻게 실행할지 고른다. Artificial Analysis Coding Agent Index에서 Fusion Max는 Opus 5.5 Max와 2점 이내의 점수를 냈고, 비용은 절반, 작업당 시간은 40% 적었다고 GitHub는 밝혔다.
점수 차이를 해석하려면 두 쪽의 모델 설정과 측정 조건이 필요하다. 블로그는 둘 다 Max 설정이라고만 적었고, 작업 집합이나 비용 산정 방식은 적지 않았다. 따라서 이 수치는 GitHub가 발표한 값으로 읽고, 자기 저장소 작업으로 비용과 소요 시간을 따로 재 보는 편이 맞다.
Projects는 오늘부터 앱에서 쓸 수 있고 공개 미리보기 단계다
Copilot projects는 여러 저장소에 걸쳐 에이전트 작업을 관리형 병렬 세션으로 돌리고, 진행 상황과 결정을 한곳에서 본다고 블로그는 소개한다. 문서에 따르면 프로젝트는 저장소를 고르지 않고도 시작할 수 있고, 목표를 주면 Copilot이 세션과 반복 자동화, 산출물 생성을 조율한다.
개요 화면은 입력 필요, 열림, 진행 중, 완료로 작업을 나눈다. 문서의 고객 피드백 분석 요청문은 예시이고, 라이브러리에 올린 자료만 쓰라고 지시하는 식으로 근거 범위를 제한할 수 있다. 공개 미리보기라서 바뀔 수 있다고 문서는 적었다.
보안 확장은 로컬 작업 사본만 고치고 커밋하지 않는다
changelog는 Fix 요청 시 Copilot이 로컬 작업 사본에만 수정을 만들고 커밋이나 푸시는 하지 않는다고 밝혔다. 사용자가 앱에서 검토하고 반복한 뒤 직접 푸시한다. 조직이 위임 알림 무시 절차를 쓰면 무시 요청은 승인으로 넘어간다.
가능한 기능과 보장되는 동작을 구분해야 한다. 수정이 정확하다는 보장은 changelog에 없고, Explain과 Fix, /security-review는 선택한 모델로 AI 크레딧을 쓴다. 알림 탐색과 무시는 AI를 쓰지 않는다. 어느 Copilot 플랜에서든 확장 설치와 /security-review는 가능하지만, Business와 Enterprise는 관리자가 앱 정책을 켜야 하고 관리자는 설치 가능한 플러그인을 통제할 수 있다. 기존 알림 조회와 수정은 code scanning이 켜진 저장소에서 권한이 있을 때 가능하고, 비공개 저장소는 GitHub Code Security가 필요하다.
Enterprise 고객은 별도 구독 없이 AI 크레딧으로 쓰고 인프라 증설도 함께 알렸다
GitHub Enterprise 고객은 오늘부터 Copilot app, 코드 리뷰, 자동화 등을 별도 구독 없이 쓰고 사용한 AI 크레딧만 낸다. 기존 Copilot Business와 Enterprise 고객은 현재 플랜을 유지하거나 옮길 수 있다. 코드 리뷰 Max는 ReviewBench의 고심각도 이슈 평가에서 가장 높은 점수를 냈다고 GitHub는 밝혔지만 점수는 적지 않았다.
인프라는 올해 CPU 코어 400만 개, 고속 저장소 160 PB, 네트워크 50 Tb/s를 더했다고 GitHub 블로그는 밝혔다. Azure 다중 리전 이전은 내년 초 완료 예정이라고 했으므로, 아직 끝난 일이 아니라 계획이다.
자세히 읽기 · GitHub의 Universe 2026 발표 글 ↗ · GitHub changelog의 Copilot app 보안 확장 ↗ · GitHub 문서의 Copilot app 프로젝트 사용법 ↗
에이전트와 연구
OpenAI, ChatGPT dot에 iMessage·RCS 문자 지원…미국 Pro 베타 한정
OpenAI가 10월 26일부터 30일까지 주간 항목으로 올린 ChatGPT Learn 안내에서 dot의 문자 기능을 소개했다. 미국 ChatGPT Pro 사용자에게 베타로 풀리며, iMessage나 Android의 RCS로 텍스트, 사진, 음성 메시지를 주고받는다.
- 대상: 미국 ChatGPT Pro 사용자, 베타.
- 채널: iMessage 또는 Android RCS의 일대일 대화.
- 승인: dot이 승인을 요청하면 ChatGPT에서 검토할 링크를 문자로 보낸다.
무엇이 달라지나
dot이 ChatGPT 앱 밖의 문자로도 사용자에게 연락할 수 있다. 대화 맥락을 바탕으로 연락 채널을 고르고, 사용자가 채널을 지정할 수도 있다. 주의가 필요한 일만 문자로 받고 일상적인 알림은 ChatGPT에 두라고 요청할 수 있다.
한계
원문은 대상을 미국 Pro 사용자로 한정했고 다른 나라나 다른 플랜의 일정은 적지 않았다. 문자 대화가 일대일이라는 점은 공식 항목에 적혀 있다. 그러나 다른 문자 대화에 접근하지 않는다는 설명은 소셜 게시물에만 있고 이 항목에서는 확인되지 않는다. 어떤 작업이 승인 대상인지, 설정 방법과 제공 지역의 세부는 항목이 링크한 별도 안내에 있어 이번에 확인한 범위 밖이다.
커뮤니티 반응
■WhatsApp과 Telegram에도 들어오기를 바라지만 곧은 아닐 것 같다는 글이 올라왔다.
■베타 테스터로 며칠 써 봤고 상당히 즐거운 경험이었다는 후기가 나왔다.
■아이폰을 쓰는데 반가운 소식이라는 답글이 달렸다.
본문 펼치기 · 약 3분
문자 채널은 dot이 사용자에게 먼저 연락하는 길을 넓힌다
ChatGPT Learn 항목에 따르면 dot은 대화 맥락을 활용해 사용자에게 어디로 연락할지 고른다. 사용자가 특정 채널을 쓰라고 요청할 수도 있어서, 주의가 필요한 일이 생기면 문자로 알리고 일상적인 업데이트는 ChatGPT에 두게 할 수 있다고 항목은 예를 든다.
문자 대화는 iMessage나 Android의 RCS를 통한 일대일 대화이고 텍스트, 사진, 음성 메시지를 지원한다. 채널을 고르는 기준이 얼마나 정확한지, 사용자가 채널을 따로 지정하지 않았을 때 어떤 일이 문자로 오는지는 항목에 구체적으로 적혀 있지 않다.
승인이 필요한 작업은 문자가 아니라 ChatGPT 링크에서 검토한다
dot이 사용자의 승인을 필요로 하면 ChatGPT에서 요청을 검토할 수 있는 링크를 문자로 보낸다고 항목은 설명한다. 승인 절차가 문자 안에서 끝나는 것이 아니라 ChatGPT 화면으로 넘어가는 구조이므로, 문자로 알림을 받은 사람이 링크를 열어 요청 내용을 읽고 판단하는 흐름이 된다.
이 설명은 승인 링크 방식이 있다는 것까지만 알려 준다. 어떤 종류의 작업이 승인 대상인지, 승인 없이 dot이 실행하는 범위가 어디까지인지는 항목에 없다. 검토 기능이 있다는 것과 실제로 보장되는 동작은 다르므로, 이 부분은 항목이 링크한 설정 안내를 따로 확인해야 한다.
미국 Pro 베타라는 조건부터 확인해야 한다
항목은 문자 기능이 베타로 미국 ChatGPT Pro 사용자에게 풀리고 있다고 적었다. 도달 채널은 iMessage 또는 Android의 RCS로 소개됐고 다른 메신저는 언급되지 않았다. 한국 사용자는 이 항목 기준으로 제공 대상이 아니다.
베타 단계라서 기능과 대상이 바뀔 수 있고, 다른 나라나 다른 플랜의 일정은 항목에 적혀 있지 않다. 항목은 문자 설정과 제공 지역의 세부를 별도 안내로 연결하는데, 그 안내는 이번에 열어 보지 못했다. 도입을 검토하는 팀은 대상 플랜과 지역, 설정 방법을 공식 문서로 먼저 확인하는 편이 맞다.
공식 항목에 없는 개인정보 설명은 소셜 게시물에서 나온 것이다
소셜 게시물 일부는 문자 대화가 사용자와 dot 사이에서만 이뤄지고 다른 문자 대화에는 접근하지 않는다고 소개했다. 항목은 일대일 대화라고만 밝히며, 다른 문자 대화에는 접근하지 않는다는 부분은 ChatGPT Learn 항목에서 확인되지 않아 공식 설명으로 읽을 수 없다. 개인정보 범위를 따지는 팀은 OpenAI의 설정 안내에서 직접 확인해야 한다.
항목에서 확인되는 것은 일대일 대화라는 점, 텍스트와 사진과 음성 메시지를 지원한다는 점, 승인이 필요하면 ChatGPT 링크로 넘어간다는 점이다. 데이터 처리나 접근 권한의 세부는 항목에 없다. 베타를 써 본 후기가 소셜 게시물로 올라왔지만 개인 경험이어서 제품 동작의 근거로 삼기는 어렵다.
자세히 읽기 · ChatGPT Learn의 Text your dot 안내 ↗
Cartesia, 토큰 없는 H-Net 연구 공개…2단 H-Net은 연산·데이터 10배 절감 주장
Cartesia가 10월 28일 연구 글 From Tokens to Bytes I를 공개했다. 2025년에 제안한 계층 네트워크 H-Net을 개선해 스케일링 결과를 낸 두 편 시리즈의 첫 글이다.
- 1단 H-Net: 토큰화만 학습형으로 바꾼 통제 비교에서 최대 3~5배의 연산 효율 이득.
- 2단 H-Net: 일치시킨 오픈소스 모델보다 좋은 성능을 연산과 데이터 10배 적게 쓰고 냈다고 Cartesia는 밝혔다.
- 범위: 생물학과 비전에서는 연구가 진행 중이다.
무엇이 달라지나
토큰화를 모델 밖의 전처리로 두지 않고, 모델이 바이트를 직접 읽으며 동적으로 묶는 구조다. BPE 토크나이저를 쓰는 Transformer와 같은 데이터, 같은 백본 설정으로 비교한 결과를 내놓았다.
한계
2단 H-Net의 비교 대상인 오픈소스 모델의 이름과 크기, 평가 항목은 확인한 원문 범위에서 나오지 않았다. 검증 손실 1.3배 등의 배율과 3~5배 연산 효율이 같은 비교의 다른 표현인지는 글 앞부분에서 확인되지 않는다. 소셜 게시물이 소개한 30억 매개변수 크기, DNA와 이미지 성과, 음성 AI 적용 계획은 확인한 원문 범위에서 나오지 않았다. 개선된 H-Net은 공개할 계획이라고 했을 뿐 아직 공개됐다는 설명은 없고, 제3자 구현은 이 글에서 다루지 않는다.
커뮤니티 반응
■AI가 글을 읽는 방식 자체가 바뀔 수도 있겠다는 반응이 나왔다.
■30억 매개변수 모델이 약 10분의 1의 학습 데이터로 기존 공개 모델과 비슷한 성능을 냈다고 소개한 글이 올라왔다.
■DNA와 이미지에서도 초기 성과를 확인했고 음성 AI에도 적용할 계획이라는 소개가 이어졌다.
본문 펼치기 · 약 3분
토큰화만 바꾼 통제 비교에서 1단 H-Net은 최대 3~5배 연산 효율을 냈다
Cartesia 글은 BPE 토크나이저를 쓴 Transformer 스케일링 사다리를 만들고, 각 단계를 같은 백본과 하이퍼파라미터의 바이트 단위 H-Net으로 바꿔 비교했다고 설명한다. 학습 데이터는 바이트 기준으로 영어 70%, 코드 20%, 수학 5%, 다국어 5%다. 지표는 토크나이저 사이에서 정규화되는 바이트당 비트(bpb)를 썼다.
비교 기준인 BPE 토크나이저는 어휘 크기 128k로 Llama-3 토크나이저에 맞췄고, 코퍼스에 맞춰 다시 학습시켜 연산 이득이 약 1.1배 더 나왔다고 글은 밝힌다. 사다리의 예시 단계는 전체 매개변수 2억 2,100만 개에서 26억 2,000만 개까지다. 검증 손실 1.3배, 코드 2배, 분포 밖 평가 2배, 도메인 밖 코드 최대 5배라는 수치도 함께 제시됐다.
2단 H-Net의 10배 절감은 연산과 데이터를 함께 말한 수치다
글은 더 유연한 2단 H-Net을 키운 결과가 일치시킨 오픈소스 모델을 앞서면서 연산과 데이터를 10배 적게 썼다고 요약한다. 비교 모델의 이름과 크기, 평가 항목은 확인한 앞부분에 없어서, 이 수치는 Cartesia의 요약으로 읽는 편이 맞다.
지표의 단위도 구분해야 한다. 검증 손실은 바이트당 비트로 잰 모델 품질 지표이고, 토큰당 바이트로 잰 평균 토큰 길이는 토크나이저의 압축 정도다. 글에 따르면 코퍼스 토크나이저는 평균 BPE 토큰 길이를 4.45바이트에서 4.57바이트로 늘렸다. 이는 처리량이 아니며, 확인한 앞부분에는 처리 속도를 직접 잰 결과가 나오지 않는다.
H-Net은 인코더가 바이트를 읽고 학습된 묶기 단계가 토큰 역할의 덩어리를 만든다
Cartesia 글의 구조 설명에 따르면 입력은 5개 모듈을 거친다. 인코더가 바이트 같은 입력을 읽고, 학습된 묶기 단계가 이를 적은 수의 덩어리로 압축하며, 본 네트워크가 토큰에 해당하는 거친 덩어리 위에서 일한다. 덩어리는 다시 입력 해상도로 풀려 잔차와 합쳐지고 디코더가 마무리한다.
1단 H-Net은 묶기를 한 번 하고, 본 네트워크 자리에 또 다른 H-Net을 넣으면 묶기가 겹쳐 2단이 된다. 글은 이렇게 겹치는 구조로 여러 수준의 추상화를 쌓을 수 있다고 설명하며, H-Net이 학습하는 패턴에서 문맥 안 토큰화 같은 새로운 행동이 보인다고 주장한다. 이는 Cartesia의 분석이며, 확인한 앞부분에는 그 사례의 규모를 보여 주는 수치가 나오지 않는다.
기초 구조라는 결론은 저자 해석이고 후속 글과 공개가 남아 있다
측정값과 저자의 해석을 나눠 읽어야 한다. H-Net이 쓴 bitter lesson에 맞는 기초 구조라는 결론과, 설계 공간을 넓힐수록 상대적 이점이 커질 것이라는 전망은 Cartesia의 해석이다. 비교 기준으로는 Kimi의 KDA와 attention residuals가 각각 1.16배와 1.25배의 연산 배수를 냈다는 수치를 글이 든다.
생물학과 비전은 진행 중인 연구이고, 더 넓은 모델 범위를 탐색하는 2부가 이어진다. 개선된 H-Net 구현은 공개할 계획이라고만 밝혔다. 현재 쓸 수 있는 코드가 아니라 연구 결과와 계획이라는 점을 구분해야 한다.
자세히 읽기 · Cartesia의 From Tokens to Bytes I ↗