2026년 10월 20일 화요일 · Fluxaivory AI 브리핑 7호 · 오전 0시 회차
30초 요약
- 미니맥스: M3.1 플래시가 API로 나왔다. 회사의 ‘업무비용 70% 감소’와 가격표에서 계산한 토큰 단가 차이는 다른 수치다.
- MOSS-Image: 글자와 사물의 배치를 제어하는 오픈 이미지 모델이 다시 소개됐다. 최초 공개는 16일이며, 영어·중국어 평가를 한국어 성능으로 읽으면 안 된다.
- 페이퍼릿: GPU 없이 논문의 일부 알고리즘을 구현해보는 실습 도구다. 문제를 통과하는 것과 논문 전체의 성능을 재현하는 것은 다르다.
오늘의 톱
미니맥스 M3.1 플래시, 단가와 ‘70% 절감’은 다르다
한 줄 요약: 미니맥스(MiniMax)가 M3.1 플래시(Flash)를 공개했다. 싼 토큰 단가는 확인할 수 있지만, 내 업무의 전체 비용이 70% 줄어든다는 보증은 아니다.
무슨 일이야?
미니맥스는 10월 19일 공식 발표에서 새 모델을 API·M 플랜(M Plan)·미니맥스 코드(MiniMax Code)에 제공한다고 밝혔다. 모델 가중치는 추후 공개할 예정으로, API 제공과 로컬 실행용 파일 배포는 구분해야 한다.
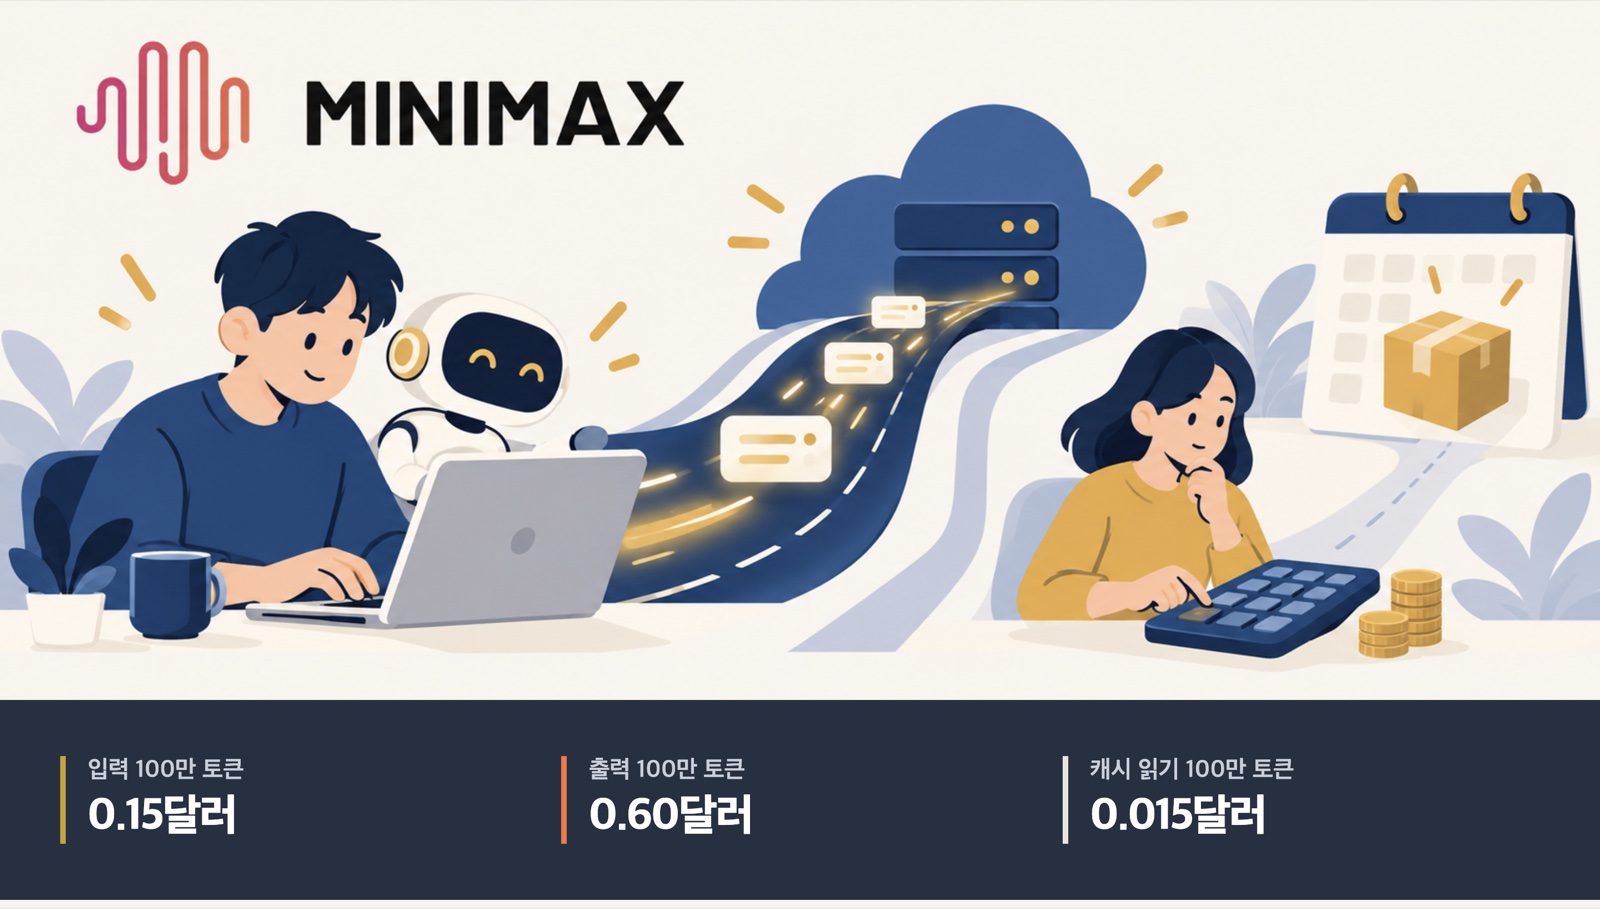
현재 가격표의 M3.1 플래시 요율은 100만 토큰당 입력 0.15달러, 출력 0.60달러, 캐시 읽기 0.015달러다. API 문서는 100만 토큰의 문맥 길이를 안내하며, 입력과 출력을 합한 한도라고 명시한다. 한글 글자 수 100만 개나 출력만 100만 토큰을 보장하는 뜻은 아니다.
궁금한 것
Q. 지금 써볼 수 있어? 회사 발표는 API와 M 플랜, 데스크톱용 미니맥스 코드를 현재 이용 경로로 든다. 같은 발표는 모델 가중치를 추후 공개하겠다고 적는다. 이번에 읽은 공식 블로그 본문만으로 구체적인 배포일이나 파일 공개 완료를 확정할 수는 없다. 무료 체험 조건이나 한국 계정의 가입·결제 가능 여부는 이 브리핑에서 확인하지 않았다.
Q. 가격표도 기존 모델보다 70% 싸진 거야? 같은 수치로 읽으면 안 된다. 가격표의 M3 표준 요율 중 입력 51만 2,000토큰 이하 구간은 입력 0.30달러·출력 1.20달러다. 이 구간과 M3.1 플래시의 입력·출력 단가를 각각 비교하면 절반이다. 회사의 ‘에이전트 작업에서 전체 사용비용 70% 감소’는 발표문의 별도 측정 주장이다.
Q. 작은 업무 예산은 어떻게 잡으면 돼? 단가표를 적용하면 캐시를 쓰지 않는 여러 요청의 입력 합계 100만 토큰과 출력 합계 100만 토큰은 0.75달러다. 이는 단순한 모델 토큰 요금 계산이며 세금·도구 호출·재시도·사람의 검수 등은 포함하지 않았다. 긴 답을 여러 번 다시 만들면 단가가 싸도 총비용은 늘 수 있으므로, 완료한 작업 한 건의 비용을 따로 비교하는 편이 낫다.
Q. 클로드나 딥시크보다 더 잘해? 회사 블로그는 코딩 평가 딥스위(DeepSWE) v1.1에서 73.7%를 보고했다. 이것은 특정 평가의 회사 측정이며 모든 코딩·문서·한국어 작업의 우위는 아니다. 한국어 품질이나 내 저장소에서의 성공률을 독립적으로 확인하지 않았으므로, 민감하지 않은 같은 과제를 기존 모델과 비교해야 한다.
주의할 점
‘온라인 추론이 약 3배 빠르다’와 ‘업무비용 70% 감소’는 회사 발표의 주장이다. 공개 가격표의 단가 차이, 같은 답을 얻는 데 필요한 토큰 수, 재시도 횟수와 검수 시간은 서로 다른 항목이다. 저렴하다는 이유로 운영 파일·결제·외부 전송 권한까지 함께 늘릴 근거는 없다.
그래서 나는?
- 개인 개발자: 실패해도 영향이 작은 과제를 골라 정답률과 총 호출 비용을 함께 비교한다. 공개 예정인 가중치를 이미 내려받을 수 있다고 가정하지 않는다.
- 팀 리더: 기존 모델과 같은 과제·완료 기준·재시도 한도를 정한다. 모델 요금과 사람이 고치는 시간을 합쳐 본 뒤 제한적으로 도입한다.
- 회사 도입 담당자: 지역별 이용 조건과 데이터 처리·보관 조건을 별도로 확인한다. 저렴한 요금표를 보안 검토의 대체물로 삼지 않는다.
숫자 더 보기 · 약 1분
가격표에서 기존 M3는 입력 길이 구간에 따라 요율이 다르다. 앞의 ‘절반’ 비교는 입력 51만 2,000토큰 이하의 표준 구간에서 입력·출력 단가만 나눈 값이다. 모든 요청 길이와 우선 처리 요금에 똑같이 적용되는 절감률이 아니다.
블로그의 DeepSWE v1.1 점수는 73.7%다. 다른 평가 버전이나 반올림한 점수를 그대로 합쳐 순위를 만들지 않았다. 이 브리핑은 해당 평가를 직접 재현하지 않았고, 회사 측정과 독립 결과를 구분한다.
AI를 우리 일에 적용하고 싶다면
먼저 시험할 업무와 사람이 확인할 경계를 정하고 싶다면 Fluxaivory 운영자에게 문의할 수 있다.
함께 볼 소식
MOSS-Image, 16일 공개 모델…한국어 성능은 별도 확인
한 줄 요약: 모스 이미지(MOSS-Image)는 글자와 사물의 위치를 구조적으로 지정할 수 있는 이미지 생성 모델이다. 영어·중국어 중심의 저자 평가와 한국어 실무에서의 품질은 구분해야 한다.
무슨 일이야?
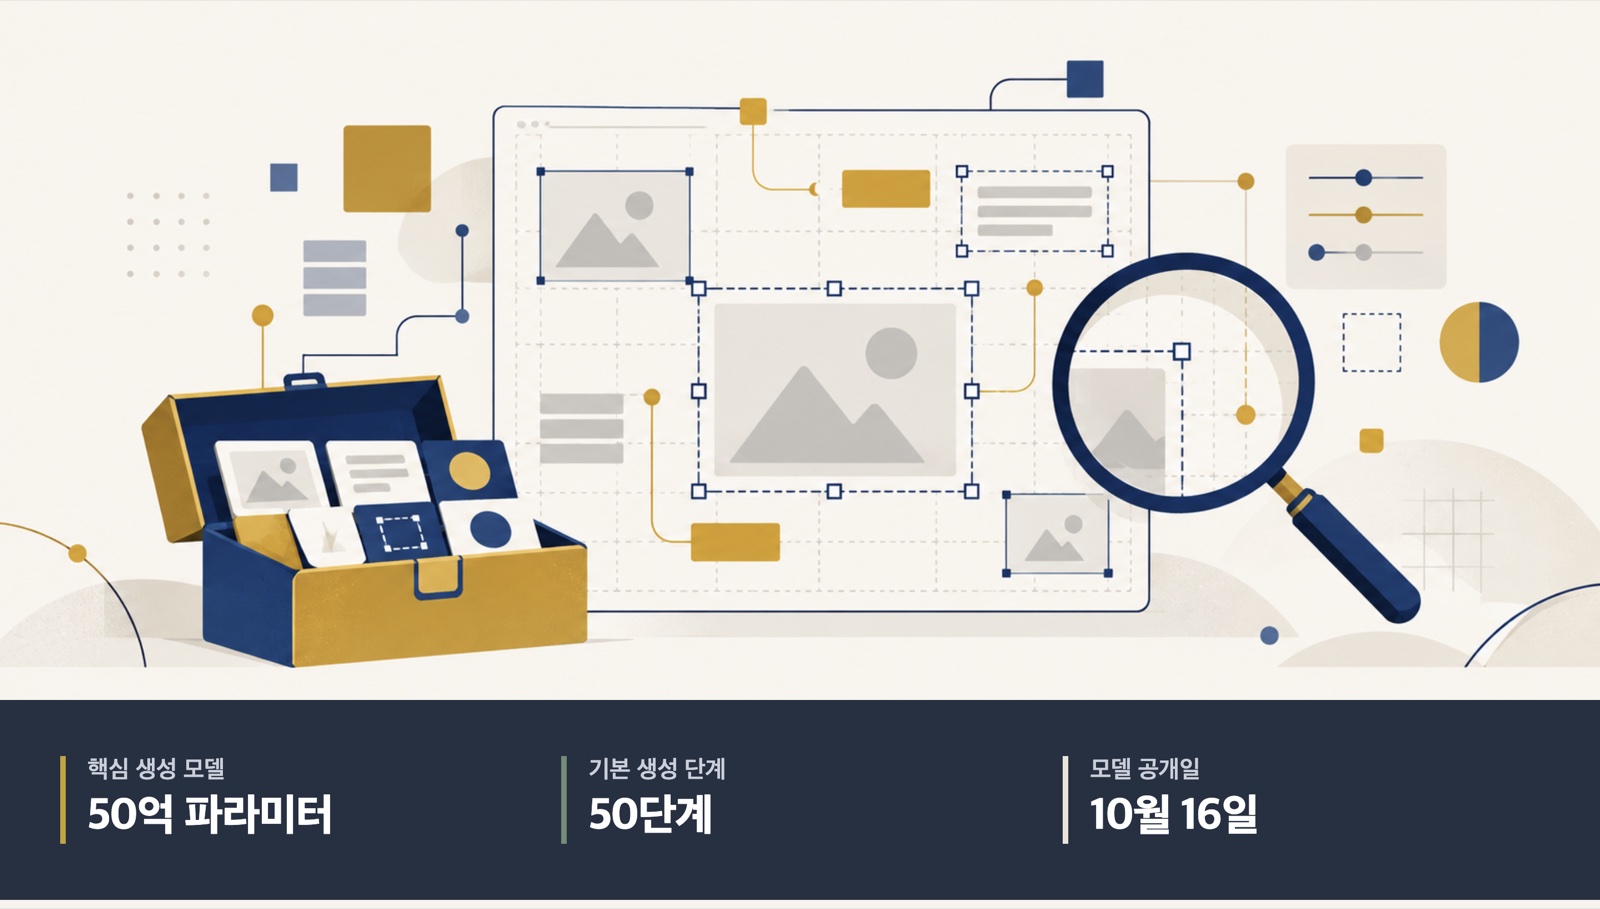
오픈모스(OpenMOSS)의 공식 저장소는 10월 16일 베이스(Base)와 에스에프티(SFT) 모델·코드의 공개를 알렸다. 이번 회차는 19일 한국어 소셜 재소개를 계기로 살펴봤으며, 19일 처음 출시된 모델로 쓰지 않았다. 저장소의 19일 기술보고서 소개와 논문 최초 제출인 16일도 서로 다른 날짜다.
모델 카드는 자연어 요청뿐 아니라 글자와 사물의 배치를 지정하는 JSON 입력을 지원한다고 설명한다. 핵심 생성 모델의 규모는 50억 파라미터이며, SFT는 선별한 데이터로 Base를 추가 학습한 모델이다. 예시 하나의 완성도를 모든 포스터와 언어에 일반화할 수는 없다.
궁금한 것
Q. 무료로 받아 회사에서 써도 돼? 모델 카드는 모델 가중치와 함께 제공하는 추론 코드를 아파치 2.0으로 공개한다고 명시한다. 라이선스 조건을 지키는 이용과 컴퓨팅 비용은 별개다. 이 조건만으로 예시 사진의 초상권이나 상표·생성 결과물의 모든 권리까지 해결됐다고 볼 수는 없다. 이 브리핑에서는 소셜에 붙은 사진을 내려받거나 재사용하지 않았다.
Q. 내 PC에서 바로 돌아가? 모델 카드의 기본 안내는 파이썬 3.10 이상, CUDA를 지원하는 엔비디아 GPU, 파이토치(PyTorch) 2.9 이상이다. 저장소는 메모리가 부족하면 CPU와 GPU 사이에 구성 요소를 옮기거나 더 느린 순차 처리를 쓰는 방법을 설명한다. 하지만 이번에 읽은 자료에는 모든 설정에 공통인 최소 GPU 메모리 수치가 없어, 일반 노트북에서 된다고 보장할 수 없다.
Q. 한국어 글자도 영어처럼 잘 만들어? 논문 초록의 긴 글자 평가 롱롱텍스트벤치(LongLongTextBench)는 영어·중국어를 대상으로 한다. 평균 텍스트 커버리지 96.3%는 그 평가의 저자 보고이며 한국어 정확도 96.3%가 아니다. 한국어 문구·줄바꿈·작은 글씨가 중요한 제작이라면 별도 표본으로 확인해야 한다.
Q. ComfyUI에서 쓸 수 있어? 공식 안내는 전용 플러그인을 제공하고 ComfyUI Manager에서 찾을 수 있다고 설명한다. 동시에 ComfyUI 공식 저장소로의 통합은 진행 중이라고 적는다. 전용 플러그인이 있다는 것과 본체에 기본 통합됐다는 것은 다르며, 이 브리핑에서는 플러그인을 설치하거나 실행하지 않았다.
주의할 점
기본 생성 설정은 모델 카드의 50단계다. 단계 수는 초 단위의 시간이 아니고, 파라미터 수도 전체 실행 메모리와 같지 않다. 배치 제어 기능이나 공개 라이선스가 문구의 정확성·권리 검수까지 대신해주지는 않는다.
그래서 나는?
- 디자이너·콘텐츠 제작자: 비민감한 문구와 배치로 먼저 확인한다. 한국어 글자와 최종 인쇄물의 검수는 사람이 맡는다.
- 로컬 모델 개발자: 가중치·코드의 이용 조건과 장비 요건을 따로 확인한다. 메모리 절약 설정에서는 속도도 함께 측정한다.
- 회사 도입 담당자: 모델을 쓸 권리와 입력·출력 이미지의 권리를 나눠 관리한다. 소셜 예시 사진을 허가 없이 홍보물에 옮기지 않는다.
출처: 모델 카드·이용 조건 · 공개일·실행·플러그인 안내 · 논문·평가 범위
페이퍼릿, GPU 없는 논문 구현 연습…전체 재현은 아니다
한 줄 요약: 페이퍼릿(PaperLeet)의 오프라인 판은 CPU에서 논문의 선택된 알고리즘을 구현하고 점검하는 연습장이다. 테스트 통과를 논문 전체의 성능이나 학습 효과가 입증됐다는 뜻으로 읽으면 안 된다.
무슨 일이야?
페이퍼릿 공식 저장소는 논문을 읽고 핵심 함수를 구현한 뒤, 작은 실험과 테스트로 이해를 확인하는 오프라인 도구를 제공한다. 19일 올라온 한국어 소개를 계기로 확인했으며, 저장소에는 15일 오프라인 CPU 판으로 바꾼 기록과 16일 문제 모음을 갱신한 기록이 있다. 19일 처음 출시됐다고 단정하지 않았다.
현재 README는 논문 49편·실습 63개·다층 점검 491개·의도적으로 틀리게 만든 구현 257개를 안내한다. 모두 프로젝트가 제시한 구성 수이며 독립적으로 센 결과나 학습 성과가 아니다. 지원 코드가 제공돼 텐서의 모양, 기울기 흐름과 핵심 수학을 구현하는 데 집중하도록 설계됐다.
궁금한 것
Q. GPU나 유료 AI 계정이 꼭 필요해? 오프라인 판 설명은 파이썬·파이토치 실행이 로컬 CPU에서 이뤄지며 GPU·계정·클라우드 API가 필요 없다고 안내한다. 다만 최초 의존성 설치에는 인터넷이 필요하다. 설치 전부터 완전히 인터넷 없이 준비할 수 있다는 뜻은 아니다.
Q. 어떤 준비가 필요해? 기본 실행 안내는 파이썬 3.10 이상, Node.js 20.19 이상, Git과 make를 든다. 웹 화면을 띄우는 설명은 macOS·Linux 셸 기준이고 Windows에서는 WSL을 쓰도록 안내한다. 터미널 실습만 하는 방법은 별도로 안내한다. 이번에는 설치와 채점기를 직접 시험하지 않았다.
Q. 한국어로 배우거나 완전 초보가 써도 돼? 프로젝트 설명의 해설과 화면은 영어·중국어이며 한국어 지원은 확인되지 않았다. 어느 정도의 파이썬과 텐서 이해를 가정하고, 파이토치의 브로드캐스팅과 자동 미분 지식이 도움이 된다고 적는다. 코딩을 처음 배우는 입문 강좌라고 보기보다는 수식과 코드를 연결하는 보조 실습으로 접근하는 편이 맞다.
Q. 문제를 통과하면 논문을 재현한 거야? README의 범위 설명은 선택된 핵심 알고리즘과 로컬 실습용의 작은 작업을 대상으로 한다. 일부 테스트 통과와 필수 모듈 전체 통과도 구분한다. 원 논문의 대규모 학습·데이터·평가를 전부 재현했거나 면접·연구 성과를 보장한다는 근거는 아니다.
주의할 점
저장소의 MIT 라이선스는 이 프로젝트의 이용 조건이다. 인용한 논문과 원 데이터의 권리까지 일괄로 바꾸는 허가는 아니다. 로컬에서 채점된다는 설명도 임의로 받은 코드를 안전 검토 없이 실행해도 된다는 보증으로 읽지 않아야 한다.
그래서 나는?
- 논문을 읽는 개발자: 이미 읽은 논문 하나의 핵심 모듈부터 골라 수식과 코드의 차이를 확인한다. 통과 수만 늘리기보다 왜 틀렸는지 설명할 수 있는지 본다.
- 스터디 운영자: 파이썬·텐서 사전 지식을 확인하고 작은 실습부터 시작한다. 문제 완료와 논문 전체 재현을 서로 다른 목표로 표시한다.
- 회사 교육 담당자: 설치·보안 검토와 교육 효과 측정을 별도로 잡는다. 프로젝트의 문제 개수를 조직의 역량 향상 수치로 바꾸지 않는다.
출처: 페이퍼릿 오프라인 공식 저장소·실행 조건·실습 범위
이미지와 정정: 이미지는 본문과 같은 수치 띠를 더한 AI 생성 일러스트로 실제 제품 화면이 아니다. MiniMax·PaperLeet 로고는 해당 회사·프로젝트의 상표이며 AI가 다시 그려 원본과 다를 수 있다. MOSS는 무로고 상징 그림이다. 정정·문의는 문의 페이지로 받을 수 있다.
질문과 검토: 실제 질문별 게시물 근거가 부족해 세 소식 모두 기본 질문을 썼으며 대표 여론이 아니다. Gemini Deep Research는 요청 1회·연구 시작 1회 뒤 30분 안에 완료를 확인하지 못해 결과를 기다리는 상태로 기록하고 공식 원문만으로 작성했다. 자동 점검과 집필과 분리된 Grok AI 검토를 거쳤으며 사람 전문가 검토는 아니다.
자료 확인: 2026년 10월 20일 KST, 오전 0시 회차다. 19일의 소셜 후보를 발굴한 뒤 공식 발표·가격표·문서·모델 카드·저장소·논문을 직접 대조한 공개 자료 종합이다. 이들 모델·플러그인·실습 도구를 설치하거나 성능을 재현하지 않았다.