2026년 10월 26일 월요일 · Fluxaivory AI 브리핑 22호 · 오전 6시 회차
난베이거(Nanbeige)가 330억 매개변수와 512K 문맥을 갖춘 코딩·사무용 모델을 공개했습니다. GPU 연산 제한 해제 프로젝트는 RTX 4090의 명령 처리량과 실제 행렬 곱셈을 각각 측정한 자료를 내놓았습니다. 마이크로소프트 사티아 나델라의 다중 모델 전략 발언까지, 새 모델과 최근 다시 소개된 실험·인터뷰를 원문 날짜와 현재 조건으로 나눠 정리했습니다.
오늘 담긴 것
- 난베이거, 330억 모델과 512K 문맥 공개: 코딩·사무 평가의 강점과 뒤진 항목, 공개 가중치 조건.
- GPU 언락, RTX 4090 명령 처리량 2배 실험: 같은 장비의 행렬 곱셈과 재부팅 뒤 결과까지 비교.
- 나델라, AI 경쟁의 중심을 제품·배포·가격으로 제시: 자동 모델 선택과 기업의 실제 선택권, 한국 데이터 조건.
오늘의 톱
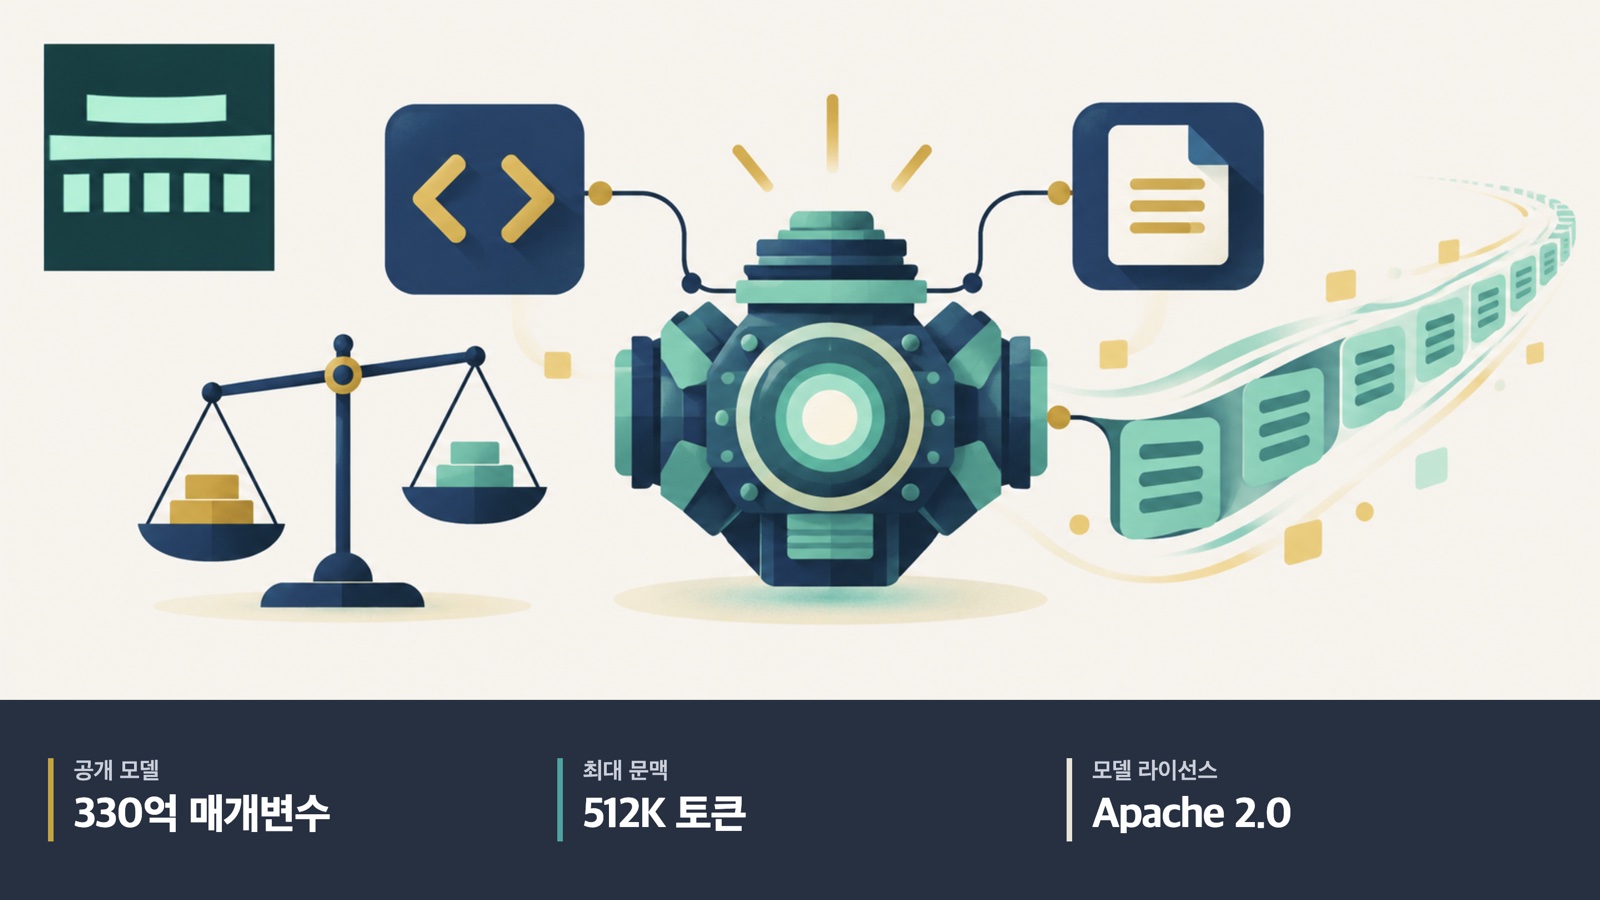
난베이거, 330억 모델 공개…512K 문맥·에이전트 강화
난베이거 연구팀이 난베이거4.3-33B(Nanbeige4.3-33B)를 공개했다. 코딩과 전문 사무 작업을 수행하고, 앞으로 만들 작은 모델을 가르칠 교사 모델 역할도 맡는다. 배포 이력에는 10월 24일 가중치 업로드와 25일 설명 문서 갱신이 남아 있다. 공식 소셜 발표는 한국 시각 25일 오후 9시 11분이며, 26일 새벽 제품 속보에서 다시 소개됐다.
- 규모: 330억 매개변수의 BF16 모델이며 최대 문맥은 524,288토큰, 즉 512K다.
- 평가: 연구팀 측정 Terminal-Bench 2.1은 80.9점, DeepSWE는 65.5점이다.
- 공개: 모델 카드는 Apache 2.0을 표시하며, 코드·도구 사용을 위한 실행 설정도 제공한다.
무엇이 달라지나
공개 가중치로 코딩과 문서 작업을 함께 검토할 선택지가 늘었다. 답변만 잘하는 모델을 찾는 대신, 여러 차례 도구를 쓰며 작업을 이어 가는 능력과 내 장비의 처리량을 함께 비교할 수 있다. 후속 소형 모델의 교사 역할도 제시해, 이번 공개는 단일 채팅 모델보다 넓은 개발 계획의 출발점이 된다.
한계
성능표는 연구팀 자체 측정이며 독립 재현 결과가 아니다. 512K는 입력 가능한 최대 문맥이지 그 길이에서의 정확도·속도 보장이 아니다. 한국어 평가와 공식 Mac 처리량·API 단가는 확인되지 않았고 직접 실행하지 않았다. 파일 용량 66.3GB는 저장 공간 수치로 GPU 최소 메모리와 같지 않다. 예고된 3B는 이번 배포 모델이 아니다.
자료
- 공식 모델 카드: 평가표, 최대 문맥, 도구 사용과 추론 설정.
- 가중치·실행 파일: BF16 배포와 전체 파일 용량.
- 배포·문서 갱신 이력: 24일 가중치와 25일 문서 갱신 구분.
- 공식 발표: 공개 목적과 후속 소형 모델 계획, 소수 게시물 기준.
- Apache 2.0 조건: 무상 이용과 저작권·라이선스 고지 유지 조건.
본문 펼치기 · 약 4분
벤치마크·비교
연구팀 비교표는 큐원3.8-27B(Qwen3.8-27B), 뮤즈 글리머30B(Muse-Glimmer-30B), 젬마4-31B(Gemma4-31B)를 같은 추론 설정과 평가 도구로 비교했다. Terminal-Bench 2.1에서 난베이거는 80.9점, 큐원은 73.0점이다. 실제 저장소의 코드를 고치는 DeepSWE에서는 각각 65.5점과 42.5점이다. 모두 연구팀이 측정한 비교다.
뒤진 항목도 모델 선택에 중요하다. 같은 표의 SWE-Bench Pro는 난베이거 60.3점, 큐원 61.7점이고, 사무 작업 평가 GDPval은 84.8점과 86.4점이다. 지식·추론 평가 GPQA Diamond에서는 난베이거 89.5점, 젬마 91.3점이다. 코딩·사무용이라는 소개를 모든 코딩 과제와 문서 작업에서 1위라는 뜻으로 넓히기보다, 내가 맡길 작업에 가까운 항목부터 비교할 수 있다.
평가 버전 차이도 크다. 같은 표의 Terminal-Bench 4.0은 난베이거 23.8점, 큐원 6.3점이다. 2.1과 4.0의 점수를 서로의 성능 향상률로 계산하지 않았다. 연구팀은 2.1에는 Terminus 2를, 4.0과 DeepSWE에는 mini-swe-agent v2.4.6을 썼다고 명시한다. 모델 이름뿐 아니라 시험 버전과 도구 구성을 함께 고정하는 것이 비교의 출발점이다.
활용·적용
모델 카드는 추론을 켜는 설정과 이전 대화의 추론을 유지하는 설정을 따로 제공한다. 일반 채팅·질문 답변에서는 이전 추론 유지 옵션을 끄고, 여러 차례 도구를 쓰는 코딩·사무 작업에서는 켜도록 권한다. 공개 성능표는 이 옵션을 켠 결과다. 같은 모델이라도 채팅용 기본 설정과 에이전트용 설정을 구분해 실험 계획을 세울 수 있다.
실행 경로는 트랜스포머스(Transformers), 에스지랭(SGLang), 브이엘엘엠(vLLM)이다. 원본 파일 목록의 전체 용량은 66.3GB다. 장비 계획에서는 가중치 파일뿐 아니라 입력 길이와 동시 작업 수, 실행 엔진에 필요한 여유 공간을 함께 산정하는 편이 합리적이다. 작은 모델의 장점을 기대하는 팀이라면 우선 33B가 자기 장비와 응답 시간 목표에 맞는지부터 좁혀 볼 수 있다.
가격·조건
공개 가중치는 모델 카드에서 받을 수 있다. Apache 2.0은 전 세계에 무상 이용·수정·배포 권리를 주고 저작권과 라이선스 고지 등의 유지 조건을 둔다. 한국 개발자도 같은 공개 자료를 검토하는 경로다. 모델 이용 허가가 무상인 것과 서버·GPU·전력·운영 인력 비용이 없는 것은 별개다.
예산 비교 단위도 바꿀 필요가 있다. 클라우드 모델의 토큰 요금만 볼 때와 달리, 자체 운영은 장비 비용을 여러 작업에 나눠 부담한다. 공식 배포를 검토할 때는 하루 처리할 문서·코드 작업 수와 동시 사용자 수를 먼저 정한 뒤, 같은 완료 기준으로 외부 API와 자체 운영을 견주는 방식이 맞다. 이번 공개는 선택권을 주지만 특정 사용량의 운영비를 정해 주지는 않는다.
궁금한 것
Q. 이번에 3B 모델도 나온 것인가? 공식 소개는 이번 모델을 33B 교사 모델로 설명하고, 3B를 후속 소형 모델의 예로 든다. 지금 소개한 배포 대상은 33B다.
Q. 코딩 점수가 높으면 사무 작업도 모두 앞서는가? 연구팀 표에서 DeepSWE는 큐원보다 높지만 GDPval은 낮다. 한 모델의 종합적인 인상보다 과제별 결과로 후보를 나눌 수 있다.
Q. 일반 채팅에도 이전 추론을 계속 보존해야 하는가? 실행 권고는 일반 채팅에서는 끄고, 다단계 도구 사용에서는 켜는 쪽을 제시한다. 공개 평가의 설정과 사용 목적을 맞춰 비교하면 된다.
AI를 우리 일에 적용하고 싶다면
먼저 비교할 업무와 장비·비용·권한·검수 기준을 나누고 싶다면 Fluxaivory 운영자에게 문의할 수 있다.
함께 볼 소식
GPU 언락, RTX 4090 명령 처리량 2배 실험 공개
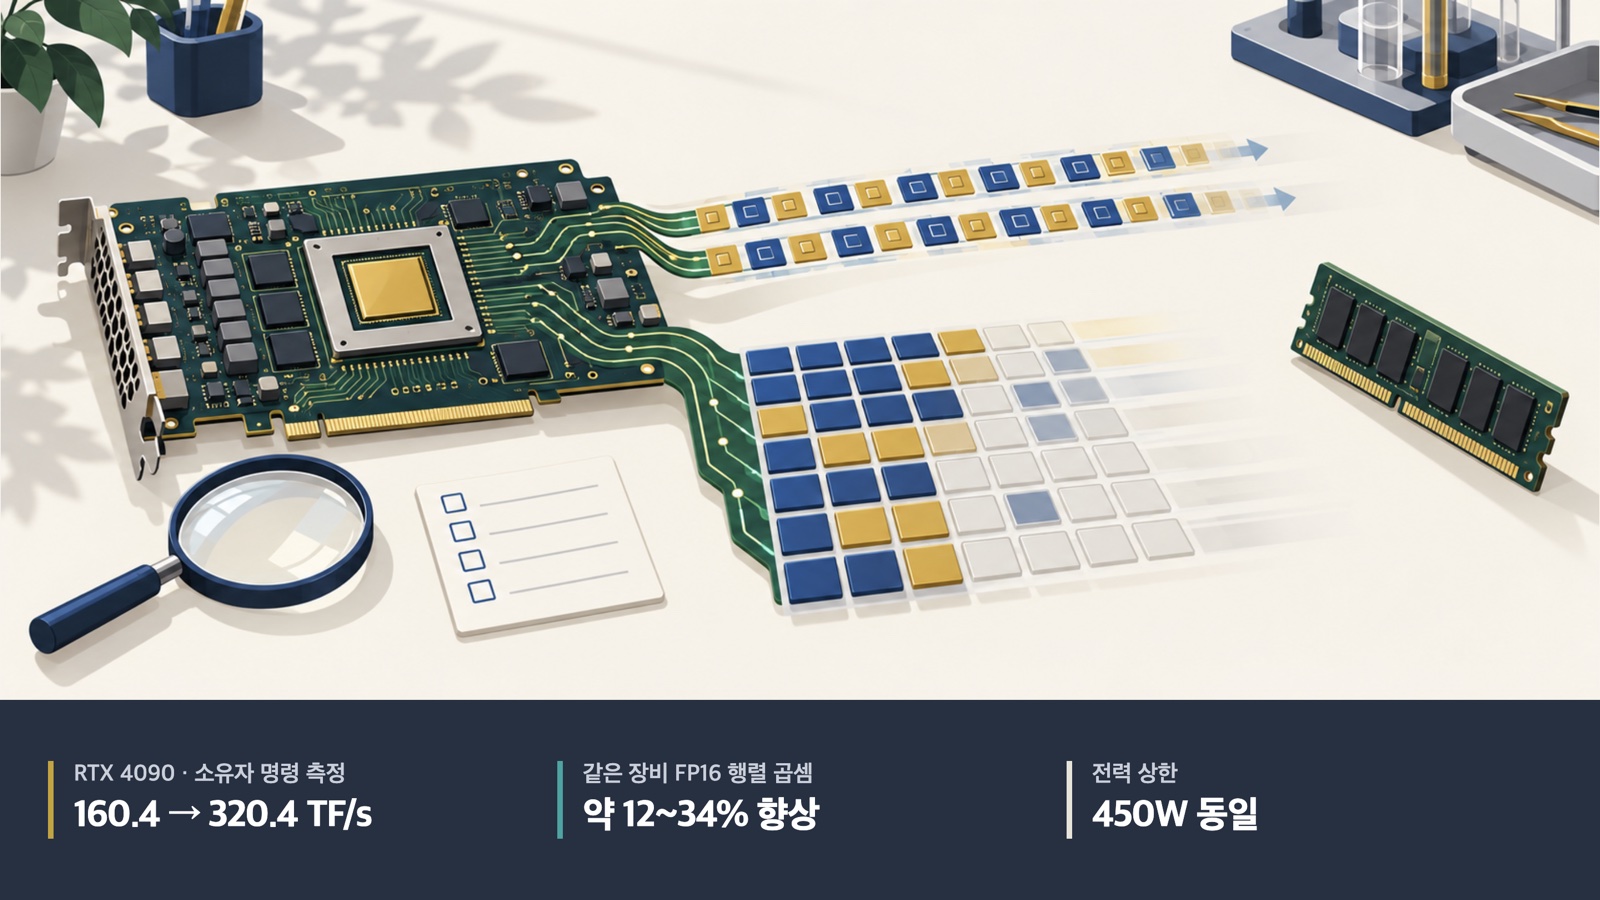
오픈소스 GPU 언락(gpu-unlock)과 에이다 포트(gpu-unlock-ada)가 소비자용 엔비디아 GPU의 일부 연산 처리량을 높이는 실험을 공개했다. 에이다 포트는 RTX 4090에서 FP16·BF16 입력을 FP32로 누적하는 명령 처리량을 약 2배로 높였다. 원 프로젝트의 최초 공개는 저장소 표기로 9월 28일, 에이다 포트의 공개 자료는 10월 23~24일이며, 이번에는 25일 한국어 재소개를 계기로 측정 내용을 확인했다.
- 명령 측정: 별도 소유자의 RTX 4090 시험에서 FP16/FP32는 160.4→320.4 TF/s, BF16/FP32는 159.7→320.2 TF/s다.
- 행렬 곱셈: 같은 장비의 cuBLAS 시험에서 FP16 향상은 크기별로 약 12~34%였다.
- 조건: 같은 GPU와 실행 파일, Linux 7.2.11·NVIDIA 615.78.08·CUDA 13.4.92, 전력 상한 450W로 비교했다.
무엇이 달라지나
장비를 새로 사는 비교 외에, 기존 GPU의 어느 연산이 제한되는지 살피는 실험 자료가 생겼다. 개발팀은 명령 처리량과 행렬 곱셈, 실제 모델 작업을 서로 다른 층으로 나눠 검토할 수 있다. 특히 수치가 움직이지 않은 항목도 함께 공개해 내 작업에 맞는 실험인지 판단할 여지가 있다.
한계
비공식 커널 모듈이며 NVIDIA가 보증한 설정이 아니다. 한 장비의 짧은 비교로 전체 AI 앱의 속도나 장기 안정성을 입증하지 못한다. 4096³ BF16 행렬 곱셈은 첫 비교에서 거의 같았고 후속 재부팅 측정에서는 8.2% 느렸다. 지원하는 RTX 40 전체 제품의 성능 보장도 아니며, 이 브리핑에서 설치·부팅 변경·시험을 하지 않았다.
자료
- 원 프로젝트: RTX 30 계열의 시험 보고와 메모리 대역폭 작업 설명.
- 에이다 포트: RTX 4090 결과와 실험적 지원 기종, 라이선스.
- 동일 장비 전후 측정: 명령·행렬 곱셈·수치 검사와 재부팅 뒤 결과.
- 한국어 재소개: 25일 게시물, 소수 게시물 기준.
본문 펼치기 · 약 3분
벤치마크·비교
별도 소유자의 전후 측정은 동일 GPU와 실행 파일, 동일한 전력 상한 450W를 사용했다. 명령 시험은 20,000회 반복과 다섯 차례 타이밍 중 최선값을 썼다. FP16/FP32는 1.998배, BF16/FP32는 2.005배였다. 같은 표의 INT8/INT32는 0.999배, 정수 내적 명령은 1.000배, 일반 FP32 연산은 0.999배다. 범용적인 GPU 점수 하나가 오른 것보다 특정 명령 경로의 변화로 해석하는 편이 정확하다.
실제 행렬 곱셈은 다른 모양을 보인다. 같은 자료의 FP16 중앙값은 1024³에서 1.190배, 4096³에서 1.344배, 8192³에서 1.120배다. 열 차례 예열 뒤 스무 번씩 실행하고 다섯 번의 타이밍을 비교했다. 명령 시험의 최고값과 행렬 곱셈의 중앙값은 측정 방식부터 다르다.
처음 공개한 4090 수치와 별도 소유자 수치도 분리했다. 프로젝트 소개는 초기 FP16/FP32 165.6→331.6 TF/s를, 동일 장비 자료는 160.4→320.4 TF/s를 제시한다. 서로 다른 시험의 시작값과 끝값을 섞어 배율을 만들지 않았다. 이미지 수치 띠는 후자의 같은 장비 비교와 일치한다.
활용·적용
원 프로젝트는 촘촘한 행렬 연산과 모델의 입력 처리 단계 등에서 얻는 이득을 소개하고, 메모리 대역폭에 묶인 LLM 출력 생성은 대체로 그대로라고 설명한다. 긴 입력을 한 번에 처리하는 작업과 토큰을 하나씩 내보내는 작업을 나눠 보는 이유다. GPU를 주로 쓰는 서비스라도 실제 시간이 어디에 쓰이는지에 따라 기대할 이득은 달라진다.
에이다 포트의 기종 목록은 RTX 4090과 실험적으로 확인한 4070 Ti SUPER·4060 Ti 16GB를 구분한다. 4060 Ti 항목에는 같은 카드의 원래 처리량과 비교한 시험이 아직 없다고 적었다. 이처럼 지원 목록에 이름이 있다는 사실과 향상 폭을 측정했다는 사실은 다르다. 장비 도입 검토에서는 내 카드·드라이버·운영 환경에 대응하는 결과가 무엇인지 문서부터 구분할 수 있다.
공개 경로는 GPL-2.0-only 소스다. 프로젝트는 미리 만든 펌웨어 패키지를 배포하지 않고, NVIDIA 펌웨어에는 별도 조건이 적용된다고 명시한다. 코드의 무상 공개와 펌웨어 권리, 운영 장비의 변경 승인을 각각 따로 검토하는 것이 이 자료를 활용하는 실무적인 출발점이다.
궁금한 것
Q. 2배는 어떤 수치인가? 동일 장비 측정의 특정 FP16·BF16 명령 처리량이다. 같은 자료는 cuBLAS 행렬 곱셈 결과를 별도 표로 공개했다.
Q. 전력 상한을 올려서 빨라진 것인가? 시험 조건은 두 상태 모두 기존 450W 상한과 같은 전력 정책을 유지했다. 상한과 실제 소비 전력은 구분하며, 공개 자료에는 짧은 전력·온도 표본도 들어 있다.
Q. 출력이 같은지도 검사했는가? 소유자 자료는 정해 둔 여섯 가지 FP16·BF16 수치 사례와 시험한 행렬 곱셈의 출력 검사가 일치했다고 보고했다. 검사의 대상과 범위는 해당 자료에 명시돼 있다.
나델라, AI 경쟁의 중심을 제품·배포·가격으로 제시
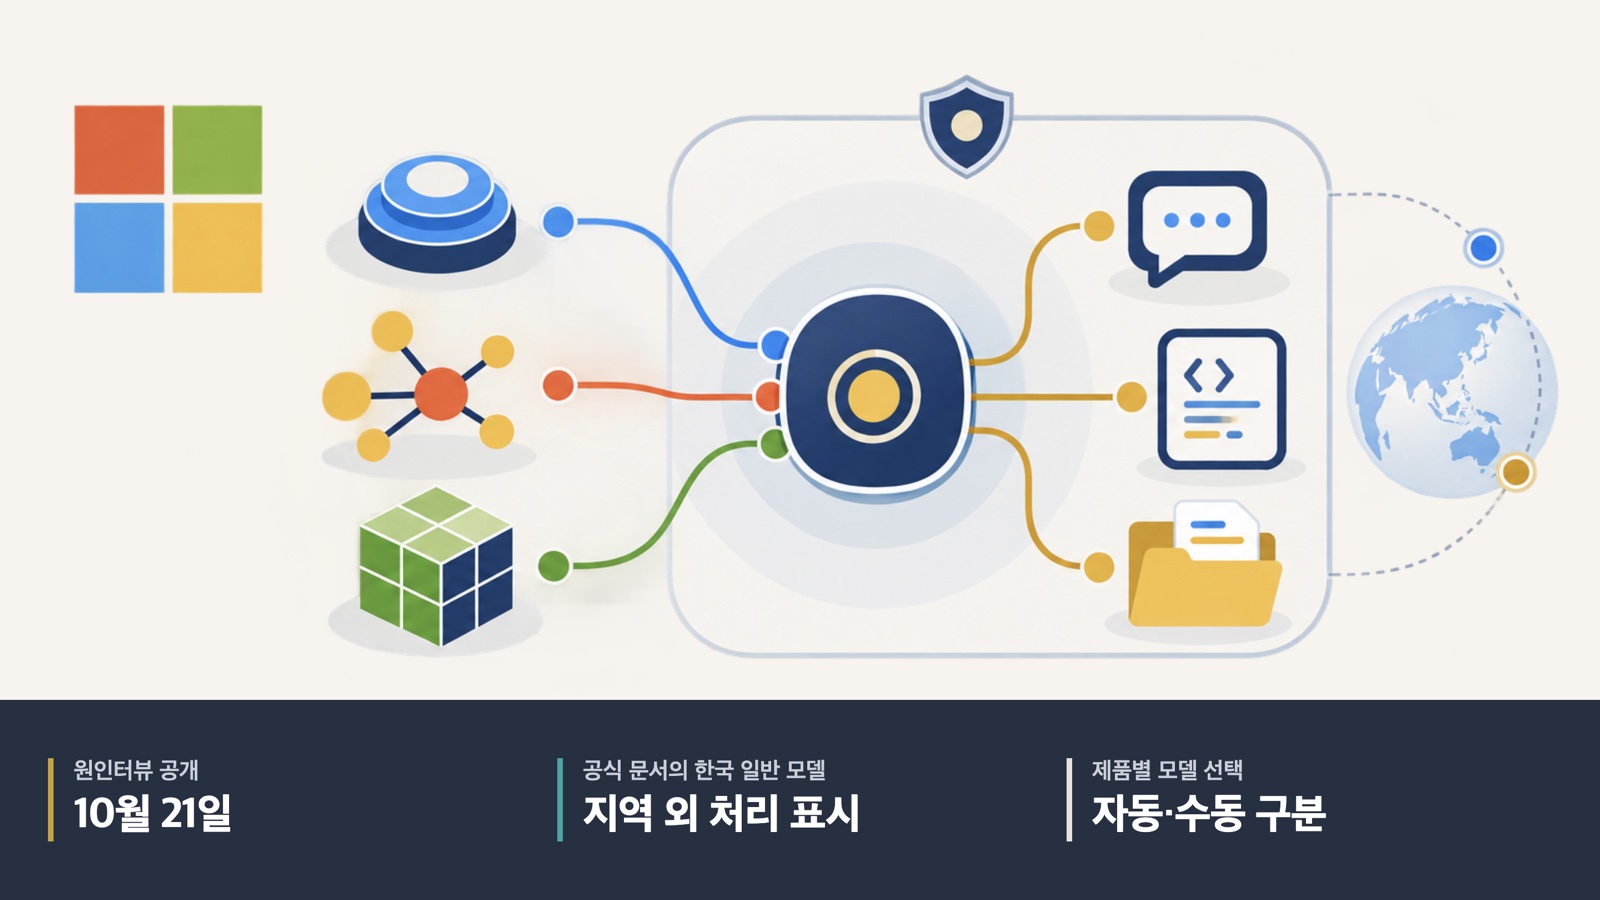
마이크로소프트(Microsoft) CEO 사티아 나델라(Satya Nadella)는 세마포어(Semafor) 인터뷰에서 하나의 모델이 모든 작업을 지배하기보다 제품의 작업 수행 능력과 배포·가격이 중요해졌다고 말했다. 영상의 유튜브 공개일 표기는 10월 21일이며, 한국 시각으로는 22일 오전 1시 12분이다. 26일 오전 5시 한국어로 다시 소개됐다. 17분 31초 이후에는 모델의 범용화와 서비스 수준 약속을, 18분대에는 코파일럿(Copilot)의 자동 모델 선택을 설명한다.
- 발언: 모델은 핵심 재료이지만, 제품 형태·유통·가격·브랜드가 함께 중요하다고 말했다.
- 선택: Copilot Studio는 에이전트의 주 모델을 고르는 설정을, Microsoft Foundry는 요청별 자동 라우팅을 제공한다.
- 국내 조건: 공식 Copilot Studio 표의 한국 일반 모델에는 지역 외 처리 표시가 붙어 있다.
무엇이 달라지나
기업이 물어볼 질문이 최고 성능 모델의 이름 하나에서, 실제 업무를 끝내는 제품의 권한·운영·비용 조건으로 넓어진다. 자동 모델 선택을 쓰더라도 관리자가 허용할 모델과 데이터 범위를 정하는 일은 남는다. 제품을 비교할 때는 사용자 화면과 관리자·개발자 설정을 함께 볼 수 있다.
한계
나델라의 경쟁 구도 해석은 회사 경영자의 견해이며 시장 전체의 성과를 입증한 결과가 아니다. 인터뷰는 새 제품 출시 공지가 아니고 Copilot·Copilot Studio·Foundry는 같은 상품이 아니다. 한국에서 선택 가능하다는 사실만으로 국내 데이터 처리가 보장되지 않으며, 이번에는 계정 연결·배포·유료 신청을 하지 않았다.
자료
- Semafor 원인터뷰: 유튜브 표기 21일·한국 시각 22일 공개, 모델과 제품 가치에 관한 직접 발언.
- Copilot Studio 주 모델 선택: 모델별 역할·한국 지역 표·관리자 허용 조건.
- Foundry 모델 라우터: 비용·품질 모드와 지원 지역, 모델 범위 설정.
- 한국어 재소개: 26일 새벽 게시물, 소수 게시물 기준.
본문 펼치기 · 약 3분
벤치마크·비교
원인터뷰의 핵심은 모델이 필요 없어졌다는 말보다 모델을 묶어 어떤 일을 끝내느냐는 주장이다. 나델라는 여러 형태의 코파일럿을 오가며 적절한 모델이 선택된다고 설명했다. 이 발언을 실제 설정과 견주면 소비자의 자동 선택 경험과 기업이 만드는 에이전트의 설정을 나눠 볼 수 있다.
Copilot Studio 문서는 관리자가 에이전트의 기본 AI 모델을 선택하는 기능을 설명한다. 응답 속도·품질·추론·비용이 선택 기준이며, 일반 모델과 깊은 추론·자동 선택 범주를 구분한다. 또한 기본 모델 선택은 별도의 깊은 추론 기능이나 응답 생성 설정과 분리된다고 명시한다. ‘제품이 알아서 고른다’는 설명만으로 관리자 선택권이 없다고 생각할 필요는 없다.
개발자용 Foundry 모델 라우터는 요청의 복잡도와 작업 유형을 분석해 기반 모델을 고른다. 기본 Balanced는 비용과 품질을 함께, Quality는 품질을, Cost는 비용을 우선하는 방식이다. Copilot Studio에서 주 모델을 고정하는 일과는 설정 단위가 다르다. 팀은 특정 모델을 재현 가능하게 고정할 작업과, 혼합 작업을 자동 배분할 부분을 나눠 설계할 수 있다.
활용·적용
한국 도입에서는 모델 선택과 데이터 처리 지역을 함께 확인할 항목으로 잡을 수 있다. Copilot Studio의 지역 표는 한국의 GPT Chat Latest·GPT-4.1·GPT-5 Chat 등 일반 모델을 지역 외 처리 가능 상태로 표시한다. 외부 공급자 모델은 조직의 지역 간 데이터 이동 허용과 공급자별 관리자 허용도 별도로 다룬다. 같은 회사의 제품이라도 이 확인 항목은 계약·업무별로 달라진다.
Foundry 문서의 지원 지역에는 Korea Central이 있고 Global Standard·Data Zone Standard 배포 유형을 구분한다. 동시에 라우팅할 모델의 부분집합을 지정하는 기능도 제공한다. 따라서 개발팀은 지역 이름만 적어 두는 대신 허용 모델 목록과 배포 유형, 데이터 처리 조건을 함께 검토할 수 있다. 라우터의 입력 사용에는 별도 요금 기준이 적용된다.
비교 작업은 한 번의 멋진 답변보다 완료 기준을 먼저 정할 때 구체적이 된다. 두 제품의 설정을 기준으로, 같은 문서·코드 과제에 필요한 도구와 권한을 고정하고 결과 품질·응답 시간·검수 시간을 나눠 기록하는 방식이다. 이는 인터뷰가 강조한 제품 가치라는 관점을 팀이 실제로 비교할 수 있는 단위로 옮기는 편집부의 제안이다.
궁금한 것
Q. 나델라가 모델 자체는 중요하지 않다고 말한 것인가? 아니다. 18분대 원발언에서 모델을 핵심 재료라고 설명하면서, 제품 형태와 배포·가격도 중요하다고 덧붙였다.
Q. 자동 선택이면 쓸 모델의 범위를 정할 수 없는가? Foundry 문서는 모델 부분집합을 지정할 수 있다고 설명한다. 자동 선택의 후보 범위와 요청별 선택은 별개의 설정이다.
Q. Copilot Studio의 주 모델 선택과 Foundry 라우터는 같은 기능인가? Studio 문서는 에이전트 주 모델 설정을, Foundry 문서는 요청별 모델 배분을 설명한다. 내가 쓰는 상품과 설정 단위부터 맞추면 된다.
이미지와 정정: 설명 그림은 수치 띠를 더한 AI 일러스트다. 로고는 해당 상표이며 원본과 다를 수 있다. 정정·문의는 문의 페이지로 받는다.
자료 확인: 2026년 10월 26일 KST 오전 6시 회차. 공식 모델·배포·측정 자료와 원인터뷰·제품 문서를 대조한 공개 자료 종합이다. 직접 실행·성능 재현은 하지 않았다. 질문은 기본 질문이며 소셜은 소수 게시물 기준으로 대표 여론이 아니다.